
Evolution API: guardando os anexos num S3
Olá meus Unicórnios! 🦄✨
A Evolution API funcionando é uma alegria: o WhatsApp virou uma API, você manda uma foto por curl e ela aparece na conversa. Aí passa uma semana, passa um mês, e chega aquela pergunta desconfortável: onde é que estão indo parar todos esses arquivos? 🤔
Foto de produto, áudio de cliente, PDF de nota, print que alguém mandou. Cada um deles é um arquivo, e por padrão eles ficam com a Evolution: no disco do contêiner e na base de dados dela. Funciona, mas é o tipo de coisa que só dá problema quando já é tarde: o disco da VPS enchendo, o backup do banco ficando gigante, e o dia em que você quiser trocar de servidor descobrindo que os arquivos estão amarrados naquela máquina.
A Evolution já tem a solução pronta, e é bem elegante: ela sabe mandar toda mídia para um S3. E como o S3 virou padrão de mercado, isso não significa obrigatoriamente pagar a Amazon: um MinIO na sua própria VPS fala exatamente a mesma língua. 📦
Este artigo é o passo a passo de ligar os dois. Não é longo, mas tem uma armadilha que engana quase todo mundo, e ela é do tipo pior: você configura tudo certinho, reinicia, e não acontece absolutamente nada. Sem erro, sem aviso, sem pista. Vamos por partes. 🙃
📋 O que você precisa ter antes de começar
Este tutorial começa no meio da história, então vale dizer de onde ele parte. Você precisa de duas coisas já funcionando:
- A Evolution API rodando, com uma instância já conectada ao WhatsApp (aquela do QR Code). Aqui ela vive em
/opt/evolution, com Docker Compose. - Um servidor S3. Se você ainda não tem, o caminho mais barato é subir um MinIO na mesma VPS: ele é um servidor de armazenamento de objetos que implementa a API do S3, roda num contêiner e não cobra por GB.
Se você não faz ideia do que é "armazenamento de objetos", a versão de bolso é esta: em vez de pastas dentro de pastas, existem buckets (baldes com nome) e objetos (os arquivos lá dentro). A Amazon popularizou isso com o S3, a API dela virou o padrão, e o MinIO implementa essa mesma API. Na prática: onde a documentação diz "S3", o MinIO serve.
Aqui eu usei um MinIO na mesma VPS da Evolution, com a API na porta 9000 e o painel web na 9001.
🪣 Primeiro o bucket, e ele não nasce sozinho
Antes de qualquer configuração, uma coisa precisa existir: o bucket. E esta é a primeira pegadinha, pequena mas certeira:
Criar é um clique no painel do MinIO (menu Buckets, botão Create Bucket) ou uma linha no terminal, se você já tem o mc, o programa de linha de comando do MinIO, configurado com um apelido:
mc mb meuminio/evolutionBucket created successfully `meuminio/evolution`.Eu chamei o meu de evolution, mas o nome é livre. Livre dentro das regras do S3, que pegam muita gente: só letras minúsculas, números, ponto e hífen. Nada de maiúscula, nada de underline. Um Anexos_WhatsApp é recusado duas vezes de uma só.
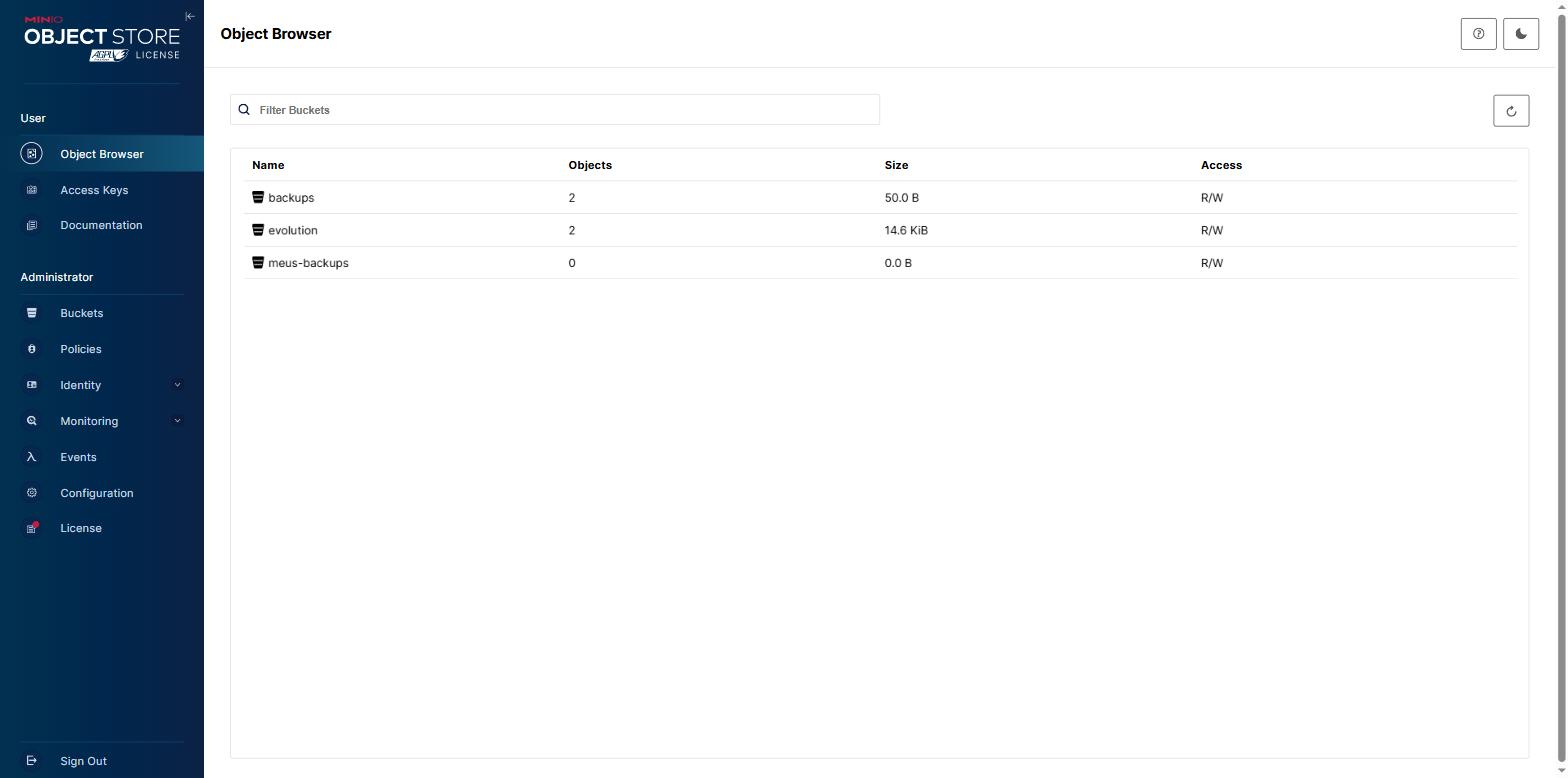
No painel, os buckets aparecem assim:
🔑 Uma credencial só para a Evolution
Agora a credencial que a Evolution vai usar para falar com o S3. Você poderia usar o usuário administrador do MinIO, e vai funcionar. Mas não faça isso. 😅
O motivo é simples: a senha do administrador é a chave do servidor inteiro, e ela vai ficar escrita num arquivo de configuração. Se um dia você precisar trocá-la, tudo que a usava para de funcionar junto. O certo é criar uma chave de acesso separada, que serve para programas e pode ser revogada sozinha.
No painel do MinIO isso fica em Access Keys, botão Create access key. Pelo terminal, é um comando:
mc admin user svcacct add meuminio SEU_USUARIO_ADMINEle devolve o par que você vai usar daqui a pouco:
Access Key: SUA_CHAVE_AQUI
Secret Key: SEU_SEGREDO_AQUI
Expiration: no-expiry🧭 Onde a Evolution enxerga o seu S3
Antes de escrever a configuração, uma pergunta que parece boba e é a causa da maioria dos problemas: qual endereço a Evolution deve usar para chegar no MinIO?
Parece óbvio, mas não é, porque quem faz a conexão não é você: é o programa de dentro do contêiner. E o mundo visto de lá dentro é diferente do seu.
Repare no que acontece quando eu tento, de dentro do contêiner da Evolution, alcançar o MinIO pelo nome do contêiner dele:
docker exec evolution-api wget -S -O /dev/null http://minio:9000/wget: bad address 'minio:9000'"Endereço ruim." E o motivo é bom de entender, porque explica metade dos perrengues com Docker: o nome do contêiner só funciona como endereço entre contêineres da mesma rede. Como a Evolution e o MinIO foram criados por dois arquivos docker-compose.yml diferentes, o Docker montou uma rede para cada, e um não enxerga o nome do outro.
Você pode conferir isso a qualquer momento:
docker network lsNETWORK ID NAME DRIVER SCOPE
6070f6a73066 bridge bridge local
c1d97334299f evolution_default bridge local
def08c3fd90d minio_default bridge localDuas redes, evolution_default e minio_default, e o nome de uma não resolve na outra.
Como cada contêiner enxerga o host (a VPS em si), e o MinIO publicou a porta 9000 no host, o caminho que sempre funciona é passar por lá. O endereço do host, visto de dentro de um contêiner, é 172.17.0.1 na instalação padrão do Docker:
docker exec evolution-api wget -S -O /dev/null http://172.17.0.1:9000/HTTP/1.1 403 ForbiddenEsse 403 parece ruim e é ótima notícia. 🎉 Ele quer dizer "tem alguém aqui, e essa pessoa está pedindo credencial" (é o AccessDenied do S3). O que a gente queria descobrir era se dá para chegar, e dá.
Então o endereço que vai na configuração depende de onde o seu S3 está. Os três casos:
- MinIO na mesma VPS, em contêiner separado: use
172.17.0.1, o host visto de dentro. - MinIO em outra máquina: use o IP dela, normalmente.
- MinIO com domínio e HTTPS: use o domínio, sem
https://na frente (isso é assunto da próxima seção).
⚙️ As variáveis, uma a uma
Agora sim, a configuração. Ela mora no arquivo .env, dentro da pasta da Evolution. Entre nela primeiro:
cd /opt/evolutionO cd é o comando de entrar numa pasta. Daqui em diante, tudo roda de dentro dela. Antes de mexer, faça uma cópia de segurança do arquivo, que é grátis e um dia salva:
cp .env .env.backupAgora abra o arquivo para editar. No Ubuntu, o editor mais simples é o nano, que já vem instalado:
nano .envA tela do terminal vira o editor, com o conteúdo atual do arquivo. Desça até o fim com as setas e acrescente estas oito linhas:
S3_ENABLED=true
S3_ACCESS_KEY=SUA_CHAVE_AQUI
S3_SECRET_KEY=SEU_SEGREDO_AQUI
S3_BUCKET=evolution
S3_PORT=9000
S3_ENDPOINT=172.17.0.1
S3_USE_SSL=false
S3_SAVE_VIDEO=true
Para colar no terminal, use Ctrl + Shift + V ou clique com o botão direito. O Ctrl + V de sempre não funciona aqui, e essa é a primeira coisa que trava quem está começando. 🙃
Para salvar e sair, são três teclas em sequência:
Ctrl + O     grava o arquivo (a letra O, de "output")
Enter        confirma o nome
Ctrl + X     sai do editor
O rodapé do nano mostra esses atalhos o tempo todo, com o ^ significando Ctrl: o ^O é Ctrl + O e o ^X é Ctrl + X.
Para conferir que ficou tudo lá, o cat mostra o conteúdo de um arquivo na tela:
cat .envE o que cada linha faz:
| Variável | O que ela diz |
|---|---|
S3_ENABLED | Liga o recurso. Sem true aqui, o resto é ignorado. |
S3_ACCESS_KEY | O usuário da credencial (a access key que você criou). |
S3_SECRET_KEY | A senha dessa credencial (o secret). |
S3_BUCKET | O nome do bucket, que precisa existir antes. |
S3_PORT | A porta do servidor S3. |
S3_ENDPOINT | O endereço, sem http:// e sem a porta. |
S3_USE_SSL | Se a conexão é por HTTPS (true) ou HTTP puro (false). |
S3_SAVE_VIDEO | Se vídeo também vai para o S3, e não só foto, áudio e documento. |
Dois detalhes que custam tempo se passarem batido:
O S3_ENDPOINT quer só o endereço. Não escreva http://172.17.0.1:9000 ali: o protocolo sai do S3_USE_SSL e a porta sai do S3_PORT. São três informações separadas de propósito, e juntá-las numa só quebra a conexão.
O S3_SAVE_VIDEO existe porque vídeo é o tipo que mais pesa. Deixe true se quiser tudo no S3, que é o normal.
🔒 Porta 9000 sem SSL, ou porta 443 com domínio
As duas variáveis que mais geram dúvida são o S3_PORT e o S3_USE_SSL, porque a resposta certa depende de como o seu S3 está publicado. E o erro clássico é misturar as duas situações. 😬
Situação 1: o MinIO cru, na rede ou na própria VPS. É o que eu fiz aqui. A porta 9000 do MinIO responde em HTTP puro, sem certificado:
S3_PORT=9000
S3_ENDPOINT=172.17.0.1
S3_USE_SSL=false
Situação 2: o MinIO atrás de um domínio com HTTPS. Se você pôs um proxy reverso na frente, com certificado, aí o endereço público é o domínio e a porta é a 443, que é a porta padrão do HTTPS:
S3_PORT=443
S3_ENDPOINT=s3.seudominio.com.br
S3_USE_SSL=true
Repare que o domínio vai sem o https://. Quem informa o protocolo é o S3_USE_SSL=true, e escrever o esquema no endereço faz a Evolution montar uma URL torta.
A regra para não errar é ler as três linhas como uma frase só: "fale com este endereço, na esta porta, usando este protocolo". Combinações como porta 9000 com S3_USE_SSL=true falham porque a Evolution tenta uma conversa criptografada com quem está respondendo em texto puro.
💀 A armadilha: o .env que não chega no contêiner
Se você só for ler um pedaço deste artigo, leia este. 🙏
Com o .env salvo, o instinto é reiniciar e testar. Foi o que eu fiz:
docker compose up -dContainer evolution-postgres Running
Container evolution-redis Running
Container evolution-api RunningE aí, nada. Nenhuma mídia no bucket, nenhum erro no log, nenhuma mudança na resposta da API. Como se eu não tivesse escrito nada. 😳
Tem duas coisas erradas nessa saída, e as duas são silenciosas.
A primeira está na palavra Running. Repare que o Docker não disse Recreated, disse Running: ele olhou e concluiu que não havia nada para fazer. Mudar o .env, sozinho, não é motivo suficiente para ele recriar o contêiner.
E a segunda é a causa raiz. Este comando pergunta ao contêiner quais variáveis S3_ ele realmente recebeu:
docker exec evolution-api env | grep S3_A resposta foi vazia. Nenhuma linha. As oito variáveis estavam no arquivo, o arquivo estava na pasta certa, e mesmo assim elas não existiam lá dentro.
O motivo está no docker-compose.yml. Este é o formato que a instalação padrão da Evolution usa:
services:
  evolution-api:
    image: evoapicloud/evolution-api:v2.3.7
    environment:
      SERVER_URL: http://SEU_IP_AQUI:8080
      AUTHENTICATION_API_KEY: ${AUTHENTICATION_API_KEY}
      DATABASE_ENABLED: "true"
      # ... e assim por diante, uma linha para cada variavel
Está tudo listado uma a uma no bloco environment:. E é isso que muda tudo: quando o compose escreve as variáveis nominalmente assim, ele passa para o contêiner exatamente as que estão nessa lista, e mais nenhuma. O .env continua sendo lido, mas só serve para preencher os ${...} que aparecem no próprio compose. O que não foi declarado ali fica de fora, em silêncio.
É por isso que o erro é tão cruel: o arquivo certo, no lugar certo, com o conteúdo certo, e nada acontece. Não há erro possível, porque, do ponto de vista do Docker, você não pediu nada.
🔧 Declarando as variáveis no compose
A correção é acrescentar as oito linhas no environment:, encadeando cada uma com o valor que vem do .env. Abra o arquivo:
nano docker-compose.ymlE acrescente estas linhas dentro do bloco environment: do serviço evolution-api, logo abaixo das que já estão lá:
      S3_ENABLED: ${S3_ENABLED}
      S3_ACCESS_KEY: ${S3_ACCESS_KEY}
      S3_SECRET_KEY: ${S3_SECRET_KEY}
      S3_BUCKET: ${S3_BUCKET}
      S3_PORT: ${S3_PORT}
      S3_ENDPOINT: ${S3_ENDPOINT}
      S3_USE_SSL: ${S3_USE_SSL}
      S3_SAVE_VIDEO: ${S3_SAVE_VIDEO}
Aquele ${S3_BUCKET} quer dizer "pegue o valor da variável S3_BUCKET do .env". É o mesmo padrão que o arquivo já usa para a senha do banco, então você está seguindo o estilo da casa, não inventando um. E é bom que seja assim: a credencial fica só no .env, e o docker-compose.yml pode até ser mostrado para alguém sem revelar segredo nenhum.
Antes de subir, peça ao próprio Docker para conferir o arquivo. São dez segundos que evitam meia hora:
docker compose configSe ele imprimir o conteúdo de volta, o arquivo está válido. Se a indentação estiver errada, ele reclama apontando a linha exata. Agora sim:
docker compose up -dContainer evolution-api Recreate
Container evolution-api Recreated
Container evolution-api Starting
Container evolution-api StartedRecreated. Essa é a palavra que a gente queria ver. 🎉 Diferente do Running de antes, ela diz que o contêiner foi refeito com a configuração nova.
E a conferência que fecha o assunto:
docker exec evolution-api env | grep S3_S3_ENABLED=true
S3_SAVE_VIDEO=true
S3_ACCESS_KEY=SUA_CHAVE_AQUI
S3_ENDPOINT=172.17.0.1
S3_BUCKET=evolution
S3_USE_SSL=false
S3_PORT=9000Agora elas existem lá dentro. A ordem sai embaralhada e isso é normal, não significa nada.
✅ O log que diz que deu certo
A aplicação demora uns 30 segundos para subir de verdade depois do up -d, então dê um tempo antes de olhar. O log é quem conta a verdade:
docker logs evolution-api | tail -20A linha que interessa é esta, e ela é bem explícita:
INFO  [S3 Service]  S3 Bucket evolution - ON
LOG   [SERVER]      HTTP - ON: 8080
S3 Bucket evolution - ON. A Evolution conseguiu falar com o S3, encontrou o bucket e ligou o recurso. Se você quiser ir direto ao ponto sem ler o log inteiro:
docker logs evolution-api | grep "S3"🩺 E quando dá errado: o erro que não explica nada
Vale ver como é a falha, porque ela é bem menos informativa do que se esperaria. Para provocá-la de propósito, troquei o S3_ENDPOINT por minio, aquele nome de contêiner que não resolve entre redes diferentes.
O log ficou assim:
ERROR  [S3 Service]  S3 ERROR:
ERROR  [S3 Service]
É isso. "S3 ERROR:" e uma segunda linha vazia, onde deveria estar o detalhe do que aconteceu. 🫠 Nada sobre endereço, nada sobre credencial, nada sobre bucket.
Pior: a aplicação sobe normalmente e continua atendendo. Mandei uma imagem com o endereço errado e ela chegou no WhatsApp igualzinho, sem reclamação nenhuma. A única diferença é que a resposta da API voltou sem o campo do S3, e o arquivo não apareceu no bucket.
Como o erro não diz o motivo, o jeito é eliminar candidatos na mão. Na ordem em que mais dão problema:
- O endereço não é alcançável. Teste de dentro do contêiner, como fizemos lá em cima, com o
wget. - O bucket não existe, ou o nome está escrito diferente do que está no
S3_BUCKET. - A credencial está errada. Copiar o segredo com um espaço no fim é clássico.
- A porta e o SSL não combinam (9000 com
true, ou 443 comfalse).
📤 A prova: mandando uma mídia
Com o ON no log, hora de provar. Mande uma imagem pela API, como você faria normalmente:
curl -X POST "http://SEU_IP_AQUI:8080/message/sendMedia/tutorial" \
  -H "apikey: SUA_CHAVE_AQUI" \
  -H "Content-Type: application/json" \
  -d '{
    "number": "SEU_DESTINO_AQUI",
    "mediatype": "image",
    "mimetype": "image/png",
    "fileName": "prova.png",
    "caption": "testando o S3",
    "media": "https://exemplo.com.br/uma-imagem.png"
  }'
Nada nesse comando mudou por causa do S3, e isso é de propósito: a configuração é invisível para quem usa a API. O que muda é a resposta, que agora traz um campo novo:
{
    "key": {
        "remoteJid": "SEU_DESTINO_AQUI",
        "fromMe": true,
        "id": "3EB0317A6C3BE67159EAB4"
    },
    "status": "PENDING",
    "message": {
        "mediaUrl": "http://172.17.0.1:9000/evolution/evolution-api/ID-DA-SUA-INSTANCIA/SEU_DESTINO_AQUI/3EB0317A6C3BE67159EAB4/imageMessage/3EB0317A6C3BE67159EAB4.png?X-Amz-Algorithm=AWS4-HMAC-SHA256&X-Amz-Credential=SUA_CHAVE_AQUI&X-Amz-Date=20260809T232411Z&X-Amz-Expires=604800&X-Amz-SignedHeaders=host&X-Amz-Signature=7ae20560f11cdbb00ad584a6a1ae57ce"
    },
    "messageType": "imageMessage"
}
Aquele mediaUrl é o troféu. 🏆 Ele não existia antes, e é a Evolution dizendo "guardei o arquivo, e ele está aqui".
Vale reparar em três coisas dentro dessa URL:
A primeira é o caminho, que não é um monte de arquivo jogado numa pasta só. A Evolution organiza por instância, depois por conversa, depois por mensagem, e no fim pelo tipo (imageMessage, documentMessage, audioMessage). Achar um arquivo específico depois vira uma questão de seguir o caminho.
A segunda é o X-Amz-Signature: é um link assinado. O bucket continua privado, e o que dá acesso é a assinatura embutida na URL. Quem pedir o mesmo arquivo sem ela leva um erro de permissão.
A terceira é o X-Amz-Expires=604800, que são sete dias em segundos. Esse link expira. Ele serve para você usar agora, não para gravar no seu banco de dados como se fosse um endereço permanente. Guarde o caminho do arquivo, e gere um link novo quando precisar.
🎯 O arquivo dentro do bucket
A prova final é olhar o bucket. Pelo terminal:
mc ls -r meuminio/evolution[2026-08-09 23:24:11] 1.6KiB .../imageMessage/3EB0317A6C3BE67159EAB4.png
[2026-08-09 23:24:23] 13KiB .../documentMessage/manual.pdfE no painel do MinIO, navegando pelas pastas até o fim:
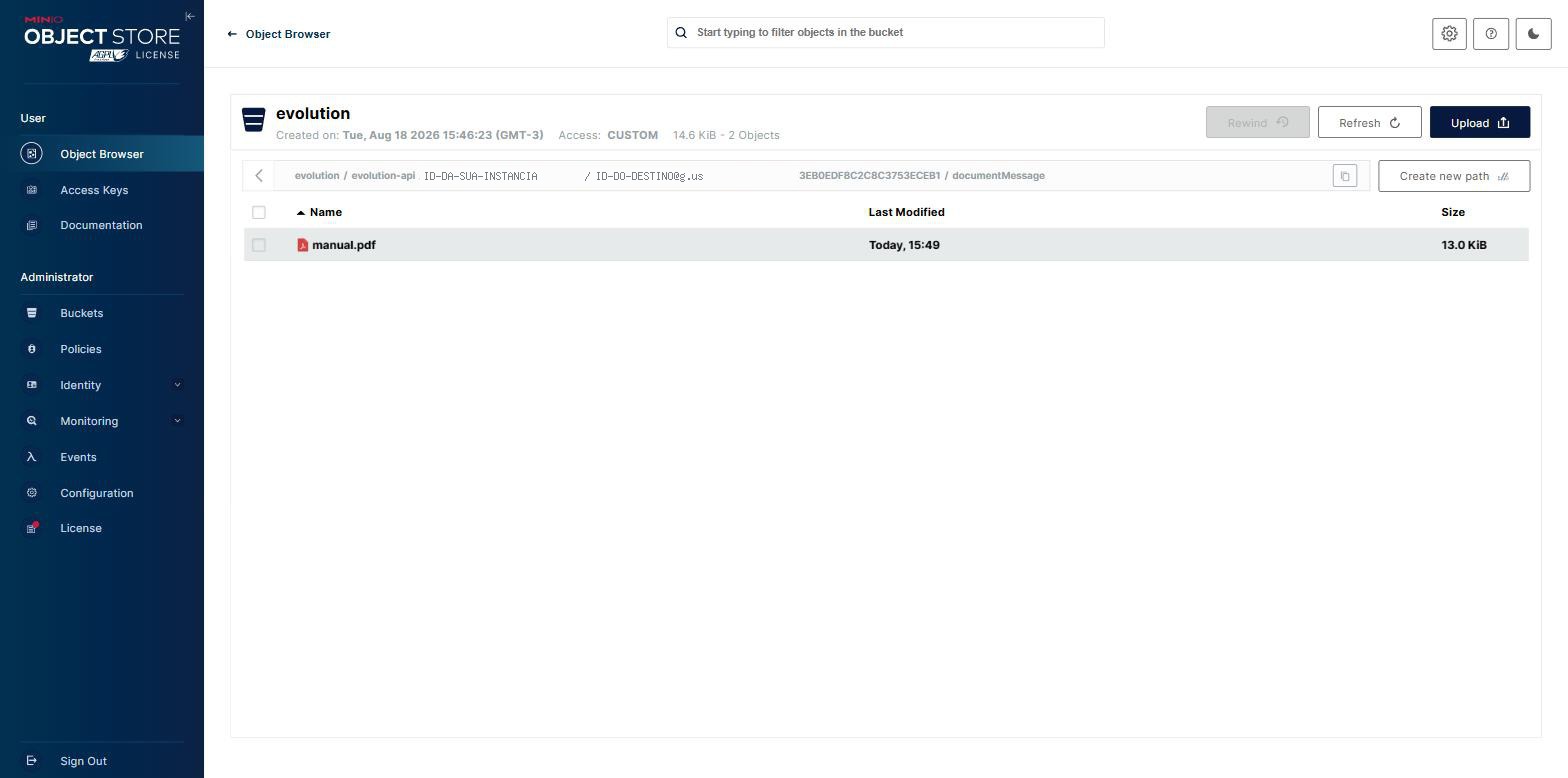
Ali está o manual.pdf que eu mandei, com 13 KiB, dentro da pasta documentMessage. 🎉
E olha um detalhe simpático: o documento manteve o nome original. Foto e áudio ganham o identificador da mensagem como nome, porque não têm nome de verdade, mas documento preserva o que veio. Isso ajuda muito na hora de procurar alguma coisa no meio de milhares de arquivos.
Se você quiser conferir que o link funciona de verdade, e não só que a URL existe, é só baixar:
curl -o baixado.png -w "HTTP %{http_code} %{size_download} bytes\n" "COLE_A_MEDIAURL_AQUI"HTTP 200 1657 bytesBaixou, com o tamanho certo. O arquivo está lá e está inteiro. ✅
📥 Recebido também vai, e é o que mais importa
Até aqui eu falei de envio, porque é o mais fácil de testar. Mas o recurso vale para os dois lados, e o lado de receber costuma ser o que enche o disco de verdade: você controla quantas fotos manda, não controla quantas te mandam. 😅
Quando alguém te envia uma mídia, a Evolution baixa o arquivo do WhatsApp, guarda no S3, e o evento que chega no seu webhook traz o mesmo mediaUrl apontando para o seu bucket. Isso muda uma coisa prática no seu sistema:
Sem S3, para pegar uma mídia recebida você precisa chamar a Evolution pedindo o conteúdo do arquivo, que vem codificado em base64 (aquele texto gigante). Com S3, você já recebe uma URL de onde baixar. É mais leve para todo mundo, e o arquivo binário para de trafegar pela sua API.
🗄️ O que fica na base de dados
Uma pergunta natural: se o arquivo foi para o S3, o que sobra no banco? Dá para espiar, porque a Evolution cria uma tabela só para isso:
docker exec evolution-postgres \
  psql -U evolution -d evolution \
  -c 'select "fileName", type, mimetype from "Media" order by id desc limit 3;'
fileName | type | mimetype
------------------------------------------+-----------------+-----------------
.../documentMessage/manual.pdf | documentMessage | application/pdf
.../imageMessage/3EB0317A6C...EAB4.png | imageMessage | image/pngRepare que o que o banco guarda é o caminho e o tipo, não o arquivo. É exatamente o que a gente queria: o banco fica com o catálogo, leve e rápido de fazer backup, e o S3 fica com o peso.
E aqui mora uma última pegadinha, que eu descobri sem querer. Lembra do teste com o endereço errado, que falhou? Aquela mensagem criou linha na tabela mesmo assim. Comparando os dois lados:
# quantas midias a base acha que existem
docker exec evolution-postgres psql -U evolution -d evolution -t \
  -c 'select count(*) from "Media";'

# quantos arquivos existem de fato no bucket
mc ls -r meuminio/evolution | wc -l
4
3Quatro na base, três no bucket. 😳 O registro do envio que falhou ficou lá, apontando para um arquivo que nunca chegou. Pedindo aquele arquivo específico, o MinIO é direto:
mc: <ERROR> Unable to stat ... Object does not exist.A lição prática: a existência do registro no banco não garante a existência do arquivo. Se o seu sistema for baixar mídia a partir dessa tabela, trate o "arquivo não existe" como um caso normal, e não como algo impossível. É o mesmo cuidado que se toma com qualquer referência a arquivo externo, só que aqui a falha vem de um endereço mal configurado que não gritou.
📼 As mídias que já estavam lá
A pergunta que sempre vem depois que tudo funciona: e o que já existia?
A resposta é curta: fica onde está. A configuração vale para o que chegar dali em diante, e não existe migração automática. A Evolution não sai varrendo o histórico para reenviar arquivo antigo, e nem seria bom que saísse: imagine ela decidindo processar meses de conversa sozinha, numa VPS pequena. 😬
Então o certo é encarar isso como uma linha divisória: antes de hoje, as mídias estão no volume do Docker e na base; a partir de hoje, elas vão para o bucket. Se o passado for grande e realmente importar, é um trabalho manual e à parte, com muito cuidado.
A boa notícia é que o custo de ligar isso é baixo. Com os dois de pé e o S3 funcionando, o consumo:
docker stats --no-streamNAME CPU % MEM USAGE / LIMIT
evolution-api 0.00% 133.8MiB / 7.755GiB
minio 1.19% 270.6MiB / 7.755GiBO MinIO em pouco mais de 270 MB de RAM e a Evolution em 133 MB. Numa VPS de 7,8 GB, os dois juntos não chegam a 6% da memória.
🧾 O resumo do que quebra
Se você chegou aqui e alguma coisa não funcionou, é quase certo que seja um destes quatro, na ordem em que eles aparecem:
| Sintoma | Causa |
|---|---|
| Nada acontece, nenhum erro, nenhuma linha de S3 no log | As variáveis não foram declaradas no environment: do compose |
docker compose up -d diz Running em vez de Recreated | O Docker não viu motivo para recriar; mexer só no .env não basta |
S3 ERROR: sem detalhe nenhum | Endereço inalcançável, bucket inexistente, credencial errada, ou porta e SSL trocados |
Mensagem chega no WhatsApp, mas não vem mediaUrl | O S3 está quebrado e a Evolution seguiu em frente sem ele |
E o comando que resolve metade das dúvidas, o que eu mais usei escrevendo isto aqui:
docker exec evolution-api env | grep S3_Ele pergunta ao contêiner, não ao arquivo. E é a diferença entre o que você acha que configurou e o que a aplicação realmente recebeu. 🔍
No fim, o que essa configuração entrega é uma separação que faz sentido: a Evolution cuida do WhatsApp, o S3 cuida dos arquivos, e cada um faz o que sabe. O disco da VPS para de crescer sozinho, o backup do banco volta a ser um backup de banco, e no dia em que você quiser trocar de servidor os arquivos não vão junto na mudança, porque nunca estiveram amarrados a ela. 🦄
Por hoje é só, meus unicórnios! 🦄✨
Que a magia do arco-íris continue brilhando em suas vidas! Até mais! 🌈🌟
Perguntas frequentes
Por que as variáveis S3 não fazem efeito mesmo estando no .env?
docker-compose.yml da Evolution lista as variáveis uma a uma no bloco environment:. O que está no .env e não foi declarado ali fica de fora e nunca chega ao contêiner. Confira com docker exec evolution-api env | grep S3_: se não sair nada, é isso.Como saber se o S3 da Evolution está funcionando?
S3 Bucket seu-bucket - ON. E na resposta de um envio de mídia aparece um campo novo, o mediaUrl, com o endereço do arquivo no seu S3. Sem S3 ligado esse campo simplesmente não existe.Qual valor usar em S3_PORT e S3_USE_SSL?
S3_PORT=9000 e S3_USE_SSL=false. Se você pôs um domínio com certificado na frente, é S3_PORT=443 e S3_USE_SSL=true. Misturar os dois (porta 9000 com SSL ligado, por exemplo) faz a conexão falhar.A Evolution cria o bucket sozinha?
S3_BUCKET. E vale a regra de nome do S3: só letras minúsculas, números, ponto e hífen.O que acontece com as mídias antigas, de antes de ligar o S3?
O link mediaUrl é público?
X-Amz-Signature e X-Amz-Expires na URL são o que dá acesso. O bucket continua privado, e quem pedir o mesmo arquivo sem a assinatura leva um erro de permissão.Leia também
OpenSEO: instalando na VPS e auditando um site
Como instalar o OpenSEO, alternativa aberta ao Semrush, numa VPS com Docker, auditar um site de verdade e entender a chave da DataForSEO.
changedetection.io: vigiando mudanças em sites na sua VPS
Instale o changedetection.io numa VPS com Docker, vigie um site com filtro CSS, receba o aviso no celular e acabe com o alarme falso do RSS.
Project NOMAD: seu servidor offline de emergência
Instale o Project NOMAD numa VPS Ubuntu e tenha Wikipédia, mapas, cursos e IA funcionando sem nenhuma conexão com a internet.