
Node.js: testando scripts de scraping no ScrapingCourse
Olá meus Unicórnios! 🦄✨
Sabe quando você escreve o seu primeiro scraper, ele roda sem erro nenhum, imprime um número bonito, e você só descobre dias depois que metade dos dados veio vazia? 😅 Pois é. Scraping é o tipo de código que falha calado: o site responde 200, o laço termina, e o que faltou não avisa que faltou.
O problema é onde treinar. Testar contra a loja de verdade de alguém é chato (você martela o servidor dos outros) e inútil para aprender (o site muda amanhã e o seu teste de hoje não serve mais).
Foi aí que eu fui parar no ScrapingCourse: um site feito para ser raspado. Cada página dele é um desafio que reproduz, de propósito, uma armadilha que você vai encontrar lá fora. Neste artigo eu passo por cinco deles em Node.js, e em cada um mostro o erro que o desafio provoca e a linha que resolve. 🦄
ScrapingCourse: sites de teste para aprender web scrapingVitrine de loja, paginação, "Load more", scroll infinito, login com CSRF, tabela e os desafios da Cloudflare.scrapingcourse.com🗺️ O que tem lá dentro
A página inicial é uma lista de desafios, cada um com o seu endereço. Estes são os que existem hoje:
| Desafio | Endereço | A armadilha que ele treina |
|---|---|---|
| Paginação | /pagination | Seguir página por página até a última |
| Carregar mais | /button-click | Botão que busca mais produtos sem trocar de página |
| Rolagem infinita | /infinite-scrolling | Produtos que chegam conforme você rola |
| Renderização por JavaScript | /javascript-rendering | Vitrine que só existe depois que o JavaScript roda |
| Tabela | /table-parsing | Extrair linhas e colunas de uma <table> |
| Login | /login | Entrar com e-mail e senha |
| Login com CSRF | /login/csrf | Formulário que exige um token escondido |
| Login com Cloudflare | /login/cf-antibot e /login/cf-turnstile | Login atrás de proteção anti-bot |
| Desafio da Cloudflare | /cloudflare-challenge | A tela "Just a moment..." |
| Desafio anti-bot | /antibot-challenge | Outra camada de detecção de robô |
E tem uma vitrine inteira de loja em /ecommerce, com página de produto, para quem quer treinar em algo mais parecido com um site real.
Escolhi cinco desafios: os três primeiros mostram jeitos diferentes de uma lista "continuar", o quarto é o login, e o quinto é o que dá errado de propósito. 🙂
🎯 Por que treinar num site feito para isso
Scraper quebrado quase nunca termina com erro. Ele termina com código de saída zero e um número que parece certo. O que denuncia o problema é ter o número certo para comparar, e isso um site de verdade não te dá: a loja muda, o produto some, a ordem troca.
No ScrapingCourse a loja é estável, então o total de hoje é o total de amanhã, e dá para conferir um caminho contra o outro. E como o site existe para isso, você pode rodar o script vinte vezes seguidas enquanto aprende, sem martelar o servidor de ninguém. 💜
🧰 Preparando a pasta
Você precisa do Node.js 20 ou mais novo. O fetch vem embutido desde o Node 18, mas o getSetCookie(), que o desafio 4 usa para ler os cookies, só chegou depois. Eu usei o Node 24. Para conferir a sua versão, digite no terminal:
node -vCrie uma pasta para os exemplos, abra o terminal dentro dela e instale uma única dependência, o cheerio:
npm install cheerioO cheerio lê um HTML e deixa você procurar os elementos com os mesmos seletores do CSS (.product-name, a[rel="next"]). Dá para tentar fazer isso com expressão regular, e o próprio ScrapingCourse mostra por que não vale a pena: na página da tabela, a célula de estoque começa numa linha e termina na outra, com o atributo content quebrado no meio. Uma regex que procura <td> linha a linha passa por ela sem ver. O cheerio lê o HTML como o navegador lê, então quebra de linha não muda nada. Aqui ele saiu na versão 1.2.0.
Para rodar cada exemplo: crie um arquivo com o nome indicado no comentário da primeira linha (por exemplo paginacao.js), cole o código, salve, e rode node paginacao.js no terminal, na mesma pasta.
📄 Desafio 1: a paginação que esconde páginas
A página /pagination mostra 12 produtos e, embaixo, a navegação: "Prev page", 1, 2, 3, "...", 13, "Next page".
A primeira ideia de quase todo mundo (a minha incluída 🙋♀️) é ler os números da navegação para saber quantas páginas existem. Fiz isso e pedi para o script listar o texto de cada link:
const cheerio = require("cheerio");

async function main() {
    const resposta = await fetch("https://www.scrapingcourse.com/pagination");
    const $ = cheerio.load(await resposta.text());

    const links = [];
    $("#pagination-container a").each(function () {
        links.push($(this).text().trim());
    });
    console.log(links);
}

main();
[ '2', '3', '13', 'Next page' ]Repare no detalhe cruel: as páginas 4 a 12 não aparecem. Elas estão escondidas atrás do "...". Um script que visita os links numerados lê 4 páginas de 13 e termina feliz, com 39 produtos em vez de 147.
O jeito certo é o que um humano faz: clicar em "Next page" até ele sumir. No HTML, esse link tem o atributo rel="next", e na última página ele simplesmente não existe:
// paginacao.js: lê todas as páginas da vitrine seguindo o link "Next page"
const cheerio = require("cheerio");

async function baixarHtml(url) {
    const resposta = await fetch(url);
    if (!resposta.ok) {
        throw new Error("A página respondeu HTTP " + resposta.status + ": " + url);
    }
    return await resposta.text();
}

function lerProdutos($) {
    const produtos = [];
    $(".product-item").each(function () {
        const nome = $(this).find(".product-name").text().trim();
        const preco = $(this).find(".product-price").text().trim();
        produtos.push({ nome: nome, preco: preco });
    });
    return produtos;
}

async function main() {
    let url = "https://www.scrapingcourse.com/pagination";
    let todos = [];
    let paginas = 0;

    while (url) {
        const html = await baixarHtml(url);
        const $ = cheerio.load(html);
        const produtos = lerProdutos($);

        paginas = paginas + 1;
        console.log("página " + paginas + ": " + produtos.length + " produtos");
        todos = todos.concat(produtos);

        // Segue o link rel="next". Na última página ele não existe e o laço termina.
        // Não conte os números da paginação: o "..." esconde as páginas do meio.
        url = $('a[rel="next"]').attr("href");
    }

    console.log("total: " + todos.length + " produtos em " + paginas + " páginas");
    console.log(JSON.stringify(todos.slice(0, 3), null, 4));
}

main().catch(function (erro) {
    console.error("Falhou: " + erro.message);
    process.exit(1);
});
O laço while (url) é o coração do script. Quando $('a[rel="next"]').attr("href") não encontra nada, devolve undefined, e o laço para sozinho. Não há número de página fixo no código, então se a loja ganhar uma página 14 amanhã, o script continua certo.
E o if (!resposta.ok) em baixarHtml não é enfeite: sem ele, uma página que respondesse 404 ou 500 seria lida como vitrine vazia, com 0 produtos e nenhum erro. É exatamente a falha calada do começo do artigo.
página 1: 12 produtos
página 2: 12 produtos
página 3: 12 produtos
página 4: 12 produtos
página 5: 12 produtos
página 6: 12 produtos
página 7: 12 produtos
página 8: 12 produtos
página 9: 12 produtos
página 10: 12 produtos
página 11: 12 produtos
página 12: 12 produtos
página 13: 3 produtos
total: 147 produtos em 13 páginas
[
    {
        "nome": "Chaz Kangeroo Hoodie",
        "preco": "$52"
    },
    {
        "nome": "Teton Pullover Hoodie",
        "preco": "$70"
    },
    {
        "nome": "Bruno Compete Hoodie",
        "preco": "$63"
    }
]
13 páginas, 147 produtos, e a última página com só 3. É esse "3" que prova que o script chegou mesmo ao fim. 🎯
🔁 Desafio 2: o "Load more" que repete produtos
A página /button-click mostra alguns produtos e um botão Load more. Não há página 2: o botão busca mais produtos e cola embaixo dos que já estão lá.
Um fetch não clica em botão nenhum. Só que o botão também não faz mágica: ele chama um endereço e recebe os produtos de lá. Para descobrir qual, abri o código-fonte da página (Ctrl+U no navegador) e procurei o <script> do botão. Ele faz isto:
fetch(`/ajax/products?offset=${offset}`)E depois soma 10 ao offset para a próxima chamada. Ou seja: dá para chamar essa rota direto, sem página e sem botão. Ela devolve um pedaço de HTML (não JSON), e quando os produtos acabam devolve uma resposta vazia, que é o sinal que a própria página usa para esconder o botão.
Aí veio a surpresa. Eu esperava 10 produtos por chamada, porque o offset anda de 10 em 10. Chegaram 12. Comparei o lote do offset=10 com o do offset=20, e os dois últimos de um eram os dois primeiros do outro. 🤯
Um scraper que só vai empilhando o que recebe fica com produto duplicado, e o número final parece perfeitamente razoável. Por isso o script guarda cada produto num Map usando o link como chave: se o mesmo link aparece de novo, ele só sobrescreve, não duplica.
// carregar-mais.js: faz o que o botão "Load more" faz, sem navegador
const cheerio = require("cheerio");

async function buscarLote(offset) {
    // O botão chama esta rota. Ela devolve um pedaço de HTML, não JSON.
    const url = "https://www.scrapingcourse.com/ajax/products?offset=" + offset;
    const resposta = await fetch(url);
    if (!resposta.ok) {
        throw new Error("A rota respondeu HTTP " + resposta.status + " no offset " + offset);
    }
    return await resposta.text();
}

async function main() {
    const vistos = new Map(); // link do produto -> nome
    let recebidos = 0;
    let offset = 0;

    while (true) {
        const html = await buscarLote(offset);

        // O site para de mandar produtos com uma resposta vazia (é o que esconde o botão).
        if (html.trim() === "") {
            break;
        }

        const $ = cheerio.load(html);
        $(".product-item").each(function () {
            const link = $(this).find("a").attr("href");
            const nome = $(this).find(".product-name").text().trim();
            recebidos = recebidos + 1;
            // Cada lote traz 12 produtos, mas o offset anda de 10 em 10:
            // os 2 últimos de um lote voltam no começo do seguinte.
            vistos.set(link, nome);
        });

        offset = offset + 10;
    }

    console.log("produtos recebidos: " + recebidos);
    console.log("produtos diferentes: " + vistos.size);
}

main().catch(function (erro) {
    console.error("Falhou: " + erro.message);
    process.exit(1);
});
Deixei o script contar as duas coisas, para você ver o tamanho do estrago:
produtos recebidos: 175
produtos diferentes: 147
28 produtos repetidos. Sem o Map, a planilha final teria 175 linhas, e nada no terminal diria que 28 delas são cópia. Repare também que o total bate com os 147 do desafio 1: é a mesma loja, lida por outro caminho, e essa conferência cruzada é um ótimo teste para qualquer scraper.
A rolagem infinita (/infinite-scrolling) usa a mesma rota com o mesmo passo de 10. Então este script também resolve o scroll infinito, sem rolar nada. 😉
👻 Desafio 3: a vitrine que só existe com JavaScript
Abrindo /javascript-rendering no navegador, está tudo lá: fotos, nomes e preços.
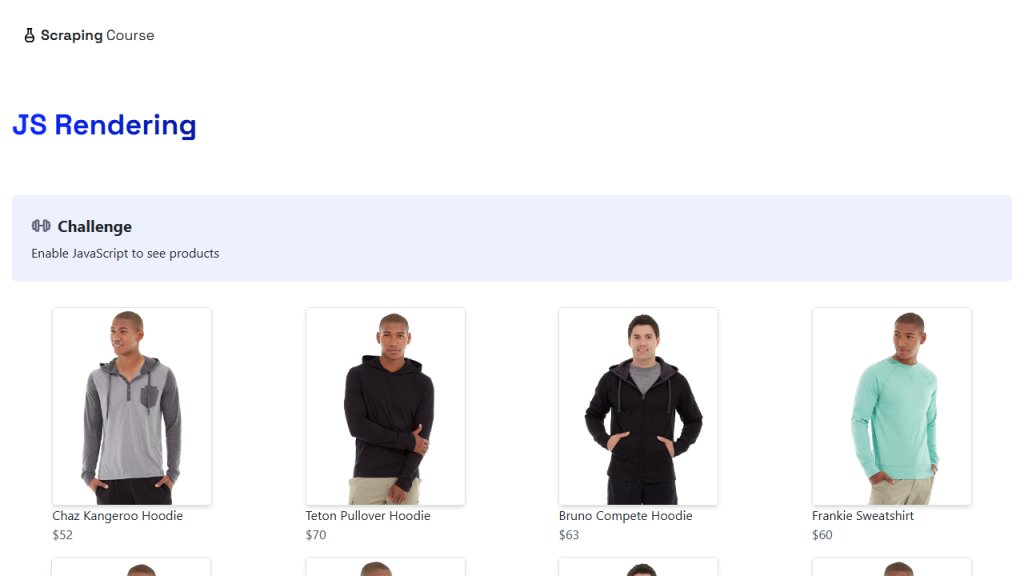
Mas o HTML que o servidor entrega é outra coisa. Ele traz os 12 cartões de produto com o nome e o preço em branco, e um script que preenche tudo depois que a página carrega. O navegador roda esse script; o fetch, não.
O pior é que o seletor funciona. Ele encontra os 12 cartões, a contagem sai certa, e só o conteúdo está vazio. Se você olhar só o número, acha que deu certo. Por isso o script abaixo faz as duas leituras lado a lado:
// pagina-javascript.js: a vitrine que só aparece depois que o JavaScript roda
const cheerio = require("cheerio");

async function lerPeloHtml() {
    const resposta = await fetch("https://www.scrapingcourse.com/javascript-rendering");
    const html = await resposta.text();
    const $ = cheerio.load(html);

    const nomes = [];
    $('[data-testid="product-name"]').each(function () {
        nomes.push($(this).text().trim());
    });
    return nomes;
}

async function lerPelaApi() {
    // É a mesma rota que o script da página chama. Achei no código-fonte dela.
    const resposta = await fetch("https://www.scrapingcourse.com/ajax/products/json");
    if (!resposta.ok) {
        throw new Error("A API respondeu HTTP " + resposta.status);
    }
    const lista = await resposta.json();

    const produtos = [];
    for (const item of lista) {
        produtos.push({ nome: item.name, preco: item.regular_price, sku: item.sku });
    }
    return produtos;
}

async function main() {
    const nomes = await lerPeloHtml();
    console.log("pelo HTML: " + nomes.length + " produtos");
    console.log(JSON.stringify(nomes.slice(0, 3), null, 4));

    const produtos = await lerPelaApi();
    console.log("pela API: " + produtos.length + " produtos");
    console.log(JSON.stringify(produtos.slice(0, 3), null, 4));
}

main().catch(function (erro) {
    console.error("Falhou: " + erro.message);
    process.exit(1);
});
pelo HTML: 12 produtos
[
"",
"",
""
]
pela API: 12 produtos
[
{
"nome": "Chaz Kangeroo Hoodie",
"preco": 52,
"sku": "MH01"
},
{
"nome": "Teton Pullover Hoodie",
"preco": 70,
"sku": "MH02"
},
{
"nome": "Bruno Compete Hoodie",
"preco": 63,
"sku": "MH03"
}
]Pelo HTML: 12 produtos, todos sem nome. Pela API: os mesmos 12, completos, e com o preço já como número (52, não o texto "$52"), o que poupa converter texto depois.
Como eu achei a rota /ajax/products/json? Do mesmo jeito do desafio 2: no código-fonte da página, o script começa com const productsUrl = '/ajax/products/json';. Nem sempre vai estar escrito assim tão à vista, mas o caminho é sempre o mesmo: antes de abrir um navegador inteiro para rodar o JavaScript, descubra de onde o JavaScript tira os dados. Muitas vezes é uma rota que devolve JSON, mais leve e mais estável que qualquer HTML. No navegador, a aba Rede (F12, depois Network, filtrando por Fetch/XHR) mostra essas chamadas acontecendo.
🔐 Desafio 4: o login com token CSRF
A página /login/csrf tem um formulário de e-mail e senha, e as credenciais de demonstração estão escritas na própria tela. Só que o formulário tem também um campo escondido:
<input type="hidden" name="_token" value="..." autocomplete="off">Esse _token é o token CSRF: um valor que o servidor gera a cada visita e confere quando o formulário volta. Ele existe para impedir que outro site envie o formulário no seu lugar, e por isso ele está amarrado à sua sessão, que vive num cookie.
Um detalhe que me pegou antes mesmo do código: no HTML baixado pelo fetch, o e-mail de demonstração não aparece. No lugar dele vem [email protected], porque a Cloudflare embaralha endereços de e-mail na página para fugir de robô coletor. Na tela do navegador ele aparece normal: [email protected], com a senha password.
O login tem três passos, e cada um tem a sua armadilha:
- Abrir o formulário e guardar duas coisas: o
_tokendo HTML e o cookie de sessão que vem no cabeçalho da resposta. - Enviar o formulário com o token no corpo e o cookie no cabeçalho.
- Abrir a área logada levando o cookie novo que o login devolveu.
O fetch do Node não guarda cookie entre uma chamada e outra (o navegador guarda, o Node não). Então o script faz esse papel com um objeto simples e duas funções pequenas:
// login-csrf.js: entra no formulário protegido por token CSRF e lê a área logada
const cheerio = require("cheerio");

const ENDERECO_LOGIN = "https://www.scrapingcourse.com/login/csrf";
const ENDERECO_PAINEL = "https://www.scrapingcourse.com/dashboard";

// O fetch do Node não guarda cookie sozinho. Este objeto faz o papel do navegador.
const cookies = {};

function guardarCookies(resposta) {
    for (const linha of resposta.headers.getSetCookie()) {
        // "nome=valor; Path=/; HttpOnly" -> fica só com "nome=valor"
        const par = linha.split(";")[0];
        const posicao = par.indexOf("=");
        cookies[par.slice(0, posicao)] = par.slice(posicao + 1);
    }
}

function montarCabecalhoCookie() {
    const partes = [];
    for (const nome in cookies) {
        partes.push(nome + "=" + cookies[nome]);
    }
    return partes.join("; ");
}

async function main() {
    // 1. Abre o formulário: é daqui que saem o token e o cookie de sessão.
    const paginaLogin = await fetch(ENDERECO_LOGIN);
    guardarCookies(paginaLogin);
    const $ = cheerio.load(await paginaLogin.text());
    const token = $('input[name="_token"]').val();
    console.log("token encontrado: " + token);

    // 2. Envia o formulário com o token E com o cookie da mesma sessão.
    const formulario = new URLSearchParams();
    formulario.append("_token", token);
    formulario.append("email", "[email protected]");
    formulario.append("password", "password");

    const envio = await fetch(ENDERECO_LOGIN, {
        method: "POST",
        headers: { Cookie: montarCabecalhoCookie() },
        body: formulario,
        redirect: "manual" // o cookie do login vem NESTA resposta; sem isso o fetch pula ela
    });
    guardarCookies(envio);
    console.log("resposta do login: HTTP " + envio.status + " -> " + envio.headers.get("location"));

    if (envio.status !== 302) {
        throw new Error("o login não foi aceito (HTTP " + envio.status + ")");
    }

    // 3. Abre a área logada levando os cookies que o login devolveu.
    const painel = await fetch(ENDERECO_PAINEL, {
        headers: { Cookie: montarCabecalhoCookie() }
    });
    const $painel = cheerio.load(await painel.text());
    console.log("saudação: " + $painel(".text-lg.font-semibold").first().text().trim());
    console.log("produtos na área logada: " + $painel(".product-item").length);
}

main().catch(function (erro) {
    console.error("Falhou: " + erro.message);
    process.exit(1);
});
token encontrado: 2aS0HZbUIq7fORXldpZvQcsYm0zZF2CNmsmO2KJS
resposta do login: HTTP 302 -> http://www.scrapingcourse.com/dashboard
saudação: Welcome, Scraper!
produtos na área logada: 12"Welcome, Scraper!" e os 12 produtos da área protegida. 🎉 Agora, as duas armadilhas, que eu provoquei de propósito para você ver a cara delas.
Armadilha 1: mandar o token e esquecer o cookie. Apaguei a linha headers: { Cookie: montarCabecalhoCookie() }, do envio. O token continua lá, certinho:
token encontrado: W78tKzbQibuWegPczSdBpT1Dxiw1ev2bm5nZX0kE
resposta do login: HTTP 419 -> null
Falhou: o login não foi aceito (HTTP 419)
HTTP 419, que no servidor deste site é a página "Page Expired". O token sozinho não vale nada: o servidor procura a sessão em que ele nasceu, e sem o cookie não há sessão. O mesmo 419 aparece se você fizer o contrário e mandar o cookie sem o campo _token.
Armadilha 2: deixar o fetch seguir o redirecionamento. Esta é a mais traiçoeira do artigo. Tirei o redirect: "manual" e também a checagem do 302 (senão ela mesma acusaria o problema):
token encontrado: rp4Q3fDp4mAYxJoHuKtxQbejjUkJN2qnjyc06t0P
resposta do login: HTTP 200 -> null
saudação:
produtos na área logada: 0
Repare: HTTP 200, nenhum erro, e zero produtos. O que aconteceu é que o login deu certo, sim. O servidor respondeu 302 mandando ir para o painel, e o cookie da sessão logada vinha nessa resposta 302. Com o redirecionamento automático, o fetch pula direto para a página seguinte e o seu código nunca vê a resposta que tinha o cookie. O painel, sem sessão, manda de volta para o login, e o 200 que chega é o da tela de login. 😳
Por isso as duas linhas trabalham juntas: o redirect: "manual" faz o fetch parar no 302 e entregar a resposta ao script, e o if (envio.status !== 302) transforma o login recusado num erro com mensagem clara, em vez de deixar o script seguir e raspar uma página vazia.
🧱 Desafio 5: a parede da Cloudflare
O último desafio é o que não passa com fetch, e é bom ver como ele falha para reconhecer quando acontecer num site de verdade.
Abrindo /cloudflare-challenge no navegador, aparece a tela de verificação:
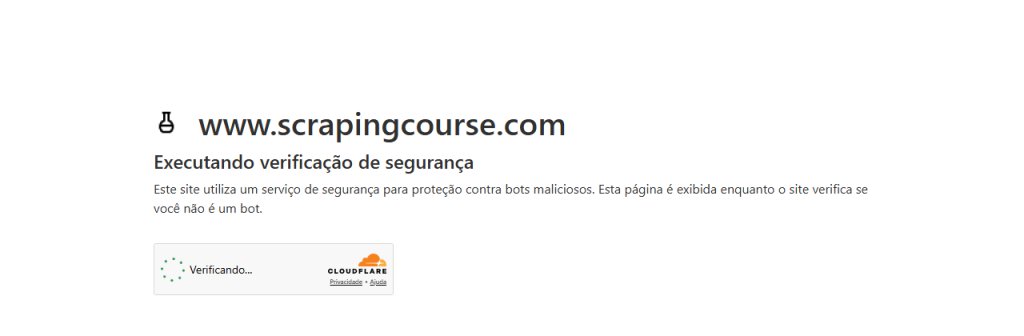
Essa tela roda um JavaScript de verificação antes de liberar a página. O fetch não roda JavaScript nenhum, então fica parado aqui:
// desafio-cloudflare.js: o que um fetch comum recebe de uma página protegida
const cheerio = require("cheerio");

const PAGINAS = [
    "https://www.scrapingcourse.com/cloudflare-challenge",
    "https://www.scrapingcourse.com/antibot-challenge"
];

async function main() {
    for (const url of PAGINAS) {
        const resposta = await fetch(url);
        const $ = cheerio.load(await resposta.text());

        console.log(url);
        console.log("  HTTP " + resposta.status);
        console.log("  título: " + $("title").text().trim());
        // O cabeçalho que denuncia o desafio: sem ele, um 403 pode ser outra coisa.
        console.log("  cf-mitigated: " + resposta.headers.get("cf-mitigated"));
    }
}

main().catch(function (erro) {
    console.error("Falhou: " + erro.message);
    process.exit(1);
});
https://www.scrapingcourse.com/cloudflare-challenge
HTTP 403
título: Just a moment...
cf-mitigated: challenge
https://www.scrapingcourse.com/antibot-challenge
HTTP 403
título: Just a moment...
cf-mitigated: challengeTrês sinais juntos: HTTP 403, o título "Just a moment..." e o cabeçalho cf-mitigated: challenge. Eu imprimo o cabeçalho de propósito: um 403 sozinho pode ser muita coisa (página proibida, IP bloqueado, rota errada). O cf-mitigated é o que diz, sem adivinhação, que foi o desafio da Cloudflare.
Vale guardar esse trio. Quando o seu scraper começar a falhar num site real, é a primeira coisa a olhar, antes de gastar uma hora achando que o seletor está errado. Passar por essa parede é assunto para outro dia; o importante aqui é o script perceber que bateu nela.
Por hoje é só, meus unicórnios! 🦄✨
Que a magia do arco-íris continue brilhando em suas vidas! Até mais! 🌈🌟
Perguntas frequentes
Posso fazer scraping do ScrapingCourse sem pedir permissão?
[email protected] e password).Por que o meu scraper acha os produtos, mas com o nome vazio?
fetch recebe tem 12 cartões de produto com o nome em branco. No ScrapingCourse o script da página busca os dados em /ajax/products/json, e ler essa rota direto devolve os 12 produtos completos, sem navegador.Por que o "Load more" me devolve produtos repetidos?
offset de 10 em 10. Os 2 últimos de um lote voltam no começo do seguinte: somando tudo, chegam 175 produtos, e só 147 são diferentes. Guardar pelo link do produto elimina as repetições.O que significa o HTTP 419 no login?
_token, e também se manda o token mas esquece o cookie da mesma sessão em que ele foi gerado.Por que o login responde 200 e mesmo assim não entra?
fetch seguiu o redirecionamento sozinho. O cookie da sessão logada vem na resposta 302, e ao seguir o redirecionamento o fetch nunca mostra essa resposta ao seu código. Use redirect: "manual" e guarde o cookie do 302.O fetch do Node consegue passar pelo desafio da Cloudflare?
/cloudflare-challenge e /antibot-challenge respondem HTTP 403 com o título "Just a moment..." e o cabeçalho cf-mitigated: challenge. O desafio precisa de um navegador rodando JavaScript, e o fetch não roda nenhum.Leia também
API Mágica: CEP e Pix de graça, sem cartão
Lancei a API Mágica: CEP, QR Code Pix, geradores e mais, de graça. Veja como consultar e gerar com Node.js em poucas linhas.
Resend: enviando e recebendo e-mails com Node.js
Tutorial da Resend com Node.js: criar a chave, enviar com fetch, verificar o domínio e receber e-mails por webhook conferindo a assinatura.
Gerando a DANFE do XML da nota com Node.js
Como ler o XML de uma NF-e em Node.js, montar o HTML do DANFE e virar PDF com o Puppeteer, com o codigo de barras da chave.