
Áudio em texto por CURL, com IA local na sua VPS
Olá meus Unicórnios! 🦄✨
Você tem um áudio de WhatsApp de três minutos que alguém te mandou e não dá para ouvir agora. Ou uma reunião gravada. Ou um monte de mensagens de voz que você precisa transformar em texto para procurar depois. 🎙️
A boa notícia é que, se você seguiu o tutorial do Ollama e Open WebUI, você já tem tudo instalado para fazer isso e nem sabia. O Open WebUI vem com o Whisper embutido.
E é aqui que mora a graça, então deixa eu ser bem clara: a IA que vai transcrever é local, roda no seu próprio servidor. 🏠 Não é a API da OpenAI disfarçada, não é serviço de nuvem com camada gratuita, não tem chave de terceiro para criar nem cartão para cadastrar. O áudio sai do seu computador, entra na sua VPS, é transcrito lá dentro e não passa por empresa nenhuma no caminho.
Isso muda o que você pode transcrever. Áudio de cliente, conversa de trabalho, gravação de reunião com dado sigiloso: o material que você não mandaria para um site aleatório de transcrição pode ir para esse, porque o servidor é seu. E não tem limite de minutos nem conta no fim do mês, já que a fatura da VPS é a mesma esteja ela transcrevendo ou parada. 💸
Hoje a gente vai mandar um arquivo de áudio por CURL e receber o texto de volta. E eu vou te contar as duas armadilhas que me pegaram no caminho, porque as duas devolvem coisas que parecem outra coisa: um erro dizendo que o formato é inválido quando o arquivo está perfeito, e uma transcrição embaralhada quando o áudio está limpinho. 😅
🎧 O que já está instalado (e você não instalou)
Essa foi a primeira surpresa boa. Eu esperava ter que instalar alguma coisa, e não precisou de nada.
O Whisper é o modelo de transcrição da OpenAI, e ele é aberto: dá para baixar e rodar na sua máquina, sem conta e sem pagar por minuto. O Open WebUI já traz uma versão dele embutida, a faster-whisper, que é uma reimplementação mais rápida do mesmo modelo.
Dá para ver isso no painel. Entre no Open WebUI, clique no seu nome no canto inferior esquerdo, vá em Configurações e depois em Áudio (na seção Admin, se você for administrador):
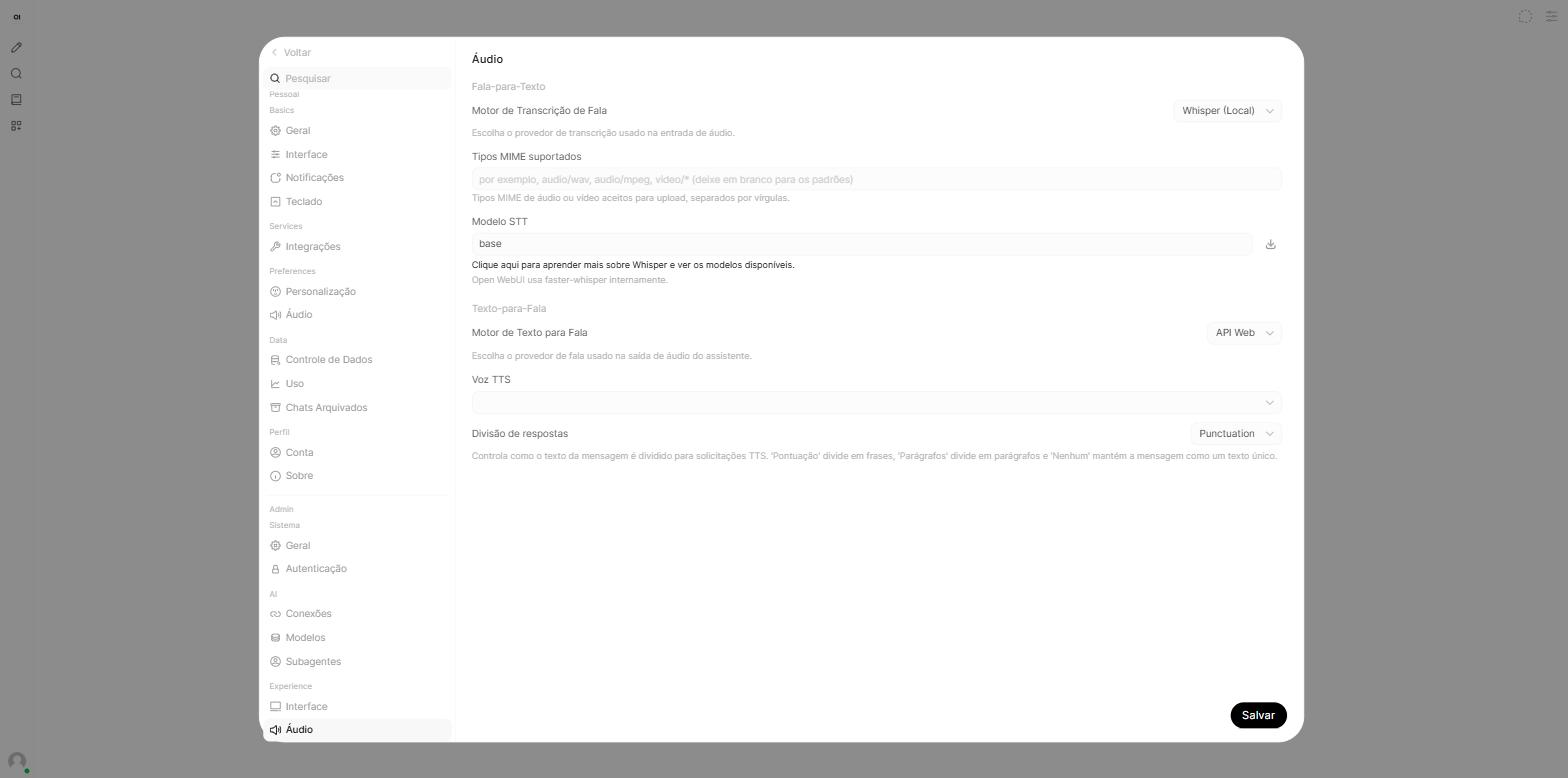
Três coisas nessa tela merecem atenção, e as três vão importar mais para a frente:
- Motor de Transcrição de Fala: Whisper (Local). É o padrão. "Local" quer dizer que roda no seu servidor: o áudio não sai da máquina.
- Modelo STT:
base. É o modelo que vem marcado. STT é speech to text, fala para texto. - Embaixo, escrito miudinho: "Open WebUI usa faster-whisper internamente". É a confirmação de qual programa está fazendo o trabalho.
Dá para conferir a mesma coisa pelo terminal, sem abrir o navegador. A configuração de áudio tem um endereço próprio na API:
curl -s http://SEU_IP_AQUI:3000/api/v1/audio/config \
  -H "Authorization: Bearer sk-SUA_CHAVE_AQUI"
Aquele -H quer dizer "mande este cabeçalho junto", e é assim que você se identifica: Authorization: Bearer seguido da sua API Key. É a chave que você gerou no artigo anterior, aquela que começa com sk- e não expira.
A resposta é comprida, mas o pedaço que interessa é este:
{
    "stt": {
        "ENGINE": "",
        "WHISPER_MODEL": "base",
        "ALLOWED_EXTENSIONS": [
            "mp3",
            "wav",
            "m4a",
            "webm",
            "ogg",
            "flac",
            "mp4",
            "mpga",
            "mpeg"
        ]
    }
}
Repare no "ENGINE": "". Vazio parece defeito, mas é o contrário: vazio significa "use o Whisper local". Se ali estivesse escrito openai ou deepgram, seu áudio estaria indo para um serviço de fora, com chave e cobrança. Vazio é o que a gente quer.
Esse campo é a prova de que a transcrição é local, e vale conferir antes de mandar áudio sério para lá. É um teste de dez segundos que responde a pergunta "será que isso está indo parar na nuvem sem eu saber?": se o ENGINE está vazio e o motor no painel diz Whisper (Local), não está. 🔍
E guarde aquela lista ALLOWED_EXTENSIONS, porque ela vai aparecer numa armadilha daqui a pouco. São nove formatos aceitos, e os que você mais vai usar são mp3, m4a (áudio de iPhone) e ogg (áudio de WhatsApp).
🇧🇷 Transcrevendo, com o comando que funciona
Você não precisa de nada além de um áudio que já tenha no computador: aquele que baixou do WhatsApp serve, e a chamada sai da sua máquina, não de dentro do servidor. É este o comando:
curl -X POST http://SEU_IP_AQUI:3000/api/v1/audio/transcriptions \
  -H "Authorization: Bearer sk-SUA_CHAVE_AQUI" \
  -F "[email protected];type=audio/mpeg" \
  -F "language=pt"
E o texto volta assim:
{
    "text": "Bom dia, hoje vamos falar sobre Inteligencia a TVC, ou em sete vídeos. O tempo é muito bom.",
    "filename": "0228a5c0-e32b-4fbf-bcbe-e760396a48a9.mp3"
}
Pronto: áudio entrou, texto saiu. 🎉 Levou 9 segundos num áudio de onze, nesta VPS sem placa de vídeo.
Agora vamos por partes, porque tem duas coisas nesse comando que parecem detalhe e não são: sem elas você recebe um erro que mente, e uma transcrição embaralhada.
📎 O ;type= que evita um erro mentiroso
Comece pela linha do arquivo:
-F "[email protected];type=audio/mpeg"O -F é o jeito de mandar formulário com arquivo (o nome técnico é multipart). O file= é o nome do campo, que a API exige que seja exatamente esse, e o @ antes do nome quer dizer "mande o conteúdo deste arquivo", não o texto "audio.mp3". Troque audio.mp3 pelo nome do seu; se ele não estiver na pasta em que você abriu o terminal, escreva o caminho inteiro (C:\Users\SeuNome\Downloads\audio.mp3).
Aquele ;type=audio/mpeg no fim é o que parece dispensável. Tire ele e a API responde isto:
{
    "detail": "Oops! It seems like the file format you're trying to upload is not supported. Please upload a file with a supported format and try again."
}
"O formato do arquivo não é suportado", num MP3 perfeitamente válido, que está em primeiro lugar na lista de formatos aceitos. 😤
O motivo aparece no log do servidor, e é sorrateiro:
INFO | open_webui.routers.audio:transcription - file.content_type: application/octet-stream
INFO | "POST /api/v1/audio/transcriptions HTTP/1.1" 400
application/octet-stream quer dizer, em bom português, "um monte de bytes, não faço ideia do que seja". Quando o curl manda um arquivo, ele não olha dentro para descobrir o que é: declara esse tipo genérico e segue a vida. E a API confere o tipo declarado, não a extensão nem o conteúdo. O arquivo está perfeito; quem está errado é o recado que vai junto com ele. 😳
Por isso o ;type=. E repare no detalhe cruel: o tipo do MP3 é audio/mpeg, com mpeg, não "audio/mp3". É uma daquelas heranças antigas da internet que não fazem sentido nenhum e você só precisa decorar. Para os formatos mais comuns:
| Se o seu arquivo é | Escreva |
|---|---|
.mp3 | ;type=audio/mpeg |
.wav | ;type=audio/wav |
.ogg (áudio de WhatsApp) | ;type=audio/ogg |
.m4a (áudio de iPhone) | ;type=audio/mp4 |
.flac | ;type=audio/flac |
🗣️ O language=pt que economiza mais de um minuto
A quarta linha do comando é a que mais parece opcional:
-F "language=pt"Esse segundo -F é um campo comum do formulário, sem @ nenhum, porque é texto e não arquivo. O pt é o código de português.
Sem ele, o Whisper tenta adivinhar o idioma sozinho. Com o mesmo arquivo, ele decidiu que era latim:
INFO | faster_whisper.transcribe - Processing audio with duration 00:11.182
INFO | faster_whisper.transcribe - Detected language 'la' with probability 0.72
E transcreveu tentando escrever latim, o que dá nisto:
{
    "text": "Bonjia! Ovi favos halar sobri dintelihen sia da qifi siau eng set vi dodi s. O tainu westa bwinto bon."
}
Não é "ele não entendeu bem uma palavra". É texto que não é português: tem sílaba, tem pontuação, e não quer dizer nada. 🫠
Com o language=pt, a detecção sai com 100% de certeza, e o relógio muda de figura junto:
Sem language=pt | Com language=pt | |
|---|---|---|
| Idioma detectado | la (latim), 72% | pt, 100% |
| Tempo | 76 segundos | 9 segundos |
| Texto | Ilegível | Compreensível |
Oito vezes mais rápido. 🤯 Faz sentido quando você pensa: um modelo convencido de que ouve latim fica reescrevendo, se corrigindo e patinando em cada trecho. Apontado para o idioma certo, ele vai direto.
Ou seja, aquele campo que parece frescura de precisão é o que separa nove segundos de mais de um minuto. Se você for transcrever uma pasta cheia de áudios, é a diferença entre almoçar e não almoçar. 🍽️
🎚️ Trocando o modelo por um mais caprichado
O base errou "inteligência artificial". Dá para melhorar isso trocando de modelo, e o Whisper tem uma escada de tamanhos: tiny, base, small, medium e large. Quanto maior, melhor e mais lento, exatamente como nos modelos de conversa do artigo anterior.
A troca é naquele campo Modelo STT da tela de Áudio: apague base, escreva small e clique em Salvar. Só isso.
E aí vem uma armadilha que não é erro, é susto: salvar não baixa nada. O modelo novo só é buscado na primeira transcrição depois da troca. Você clica em salvar, tudo parece instantâneo, e a chamada seguinte fica parada por um tempão enquanto ele baixa por baixo dos panos. Dá para ver acontecendo no log:
INFO | HTTP Request: GET https://huggingface.co/Systran/faster-whisper-small/...
INFO | faster_whisper.transcribe - Processing audio with duration 00:11.182
Repare que ele busca no huggingface.co, que é o site onde esses modelos ficam hospedados. Se o seu servidor não tiver saída para a internet, é aqui que trava.
Depois de baixado, ele fica guardado dentro do contêiner. Dá para ver o tamanho de cada um com o du, que mede pastas (o -sh quer dizer "só o total, num tamanho legível para gente"):
docker exec open-webui du -sh /app/backend/data/cache/whisper/models/*O docker exec roda um comando dentro da caixinha do Docker, já que a pasta mora lá. O resultado com os dois modelos baixados:
142M    .../models--Systran--faster-whisper-base
464M    .../models--Systran--faster-whisper-small
E o resultado da mesma frase, com o mesmo arquivo, nos dois:
base | small | |
|---|---|---|
| Disco | 142 MB | 464 MB |
| Tempo (áudio de 11 s) | ~9 s | ~18 s |
| Transcrição | "Inteligencia a TVC" | "inteligência atificial" |
O small chegou quase lá: faltou uma letra em "artificial", e ele ainda acertou os acentos, que o base tinha comido. Custou o dobro do tempo e três vezes o disco. 🤷♀️
Minha regra depois desses testes: fique no base se for áudio limpo e você só quiser a ideia geral (procurar depois, saber do que se tratava). Suba para o small quando o texto for ser lido por gente ou quando tiver nome próprio e termo técnico no meio, que é onde o modelo pequeno mais erra.
Uma coisa boa: como o cache fica no volume do Docker, o download acontece uma vez só. Reiniciar o contêiner não faz baixar de novo, e voltar para o base depois é instantâneo, porque ele continua guardado ali.
📝 Guardando a transcrição num arquivo
Até aqui o texto aparece na tela e acabou. Se você quiser guardá-lo, acrescente o -o (de output) com o nome que quiser:
curl -X POST http://SEU_IP_AQUI:3000/api/v1/audio/transcriptions \
  -H "Authorization: Bearer sk-SUA_CHAVE_AQUI" \
  -F "[email protected];type=audio/mpeg" \
  -F "language=pt" \
  -o transcricao.json
Depois é só ver o conteúdo com o cat, que mostra um arquivo na tela:
cat transcricao.jsonE se quiser só o texto, sem o JSON em volta, o jq (aquele formatador que a gente instalou no artigo passado) tem um jeito curto:
cat transcricao.json | jq -r .textO -r é de raw: ele tira as aspas e mostra o texto puro, pronto para copiar. 📋
É isso: um áudio entra, o texto sai, e nada disso passou por servidor de ninguém. Sua IA, sua máquina, seu áudio. ✨
Por hoje é só, meus unicórnios! 🦄✨
Que a magia do arco-íris continue brilhando em suas vidas! Até mais! 🌈🌟
Perguntas frequentes
O meu áudio vai para a nuvem?
GET /api/v1/audio/config, no campo stt.ENGINE: vazio significa Whisper local. Se estivesse escrito openai ou deepgram, aí sim iria para fora.Preciso instalar o Whisper separado?
faster-whisper internamente, com o motor Whisper (Local) marcado por padrão em Configurações → Áudio. Não tem chave de API, não tem serviço externo, não tem conta para criar.Por que a API responde 400 dizendo que o formato não é suportado?
curl não avisa o tipo do arquivo. Um -F "[email protected]" manda application/octet-stream, e a API confere o tipo declarado, não a extensão. A correção é -F "[email protected];type=audio/mpeg". O arquivo era válido o tempo todo.Por que a transcrição sai embaralhada mesmo com o áudio em português?
-F "language=pt" e a detecção sai com 100% de certeza.Quanto tempo leva para transcrever?
base. Sem o language=pt, o mesmo arquivo levou 76 segundos: adivinhar o idioma errado faz o modelo se perder e trabalhar muito mais.Qual a diferença entre os modelos base e small?
base ocupa 142 MB e o small, 464 MB. Na mesma frase, o base escreveu "Inteligencia a TVC" e o small acertou "inteligência atificial", quase perfeito. Em troca, o small levou cerca de 18 s contra 9 s.Leia também
Texto em áudio por CURL, com IA local na sua VPS
Transforme texto em áudio com IA local, por CURL. O Open WebUI não tem TTS embutido: instale o motor, baixe a voz brasileira e ligue os dois.
Ollama e Open WebUI: sua própria IA numa VPS
Instale Ollama e Open WebUI numa VPS por SSH, baixe outros modelos, veja quais valem a pena sem GPU e gere a API Key para usar a API.
Clonar voz por API, com IA local na sua VPS
Clone a sua voz com IA local e cadastre vozes por API: suba o Chatterbox, envie o .wav por HTTP e gere áudio em português no seu servidor.