
Busca semântica no Qdrant: digitando o que você quer
Olá meus Unicórnios! 🦄✨
No artigo passado a gente instalou o Qdrant numa VPS e fez a primeira busca por semelhança, com quatro frutinhas e vetores que eu escrevi à mão. E veio na hora a pergunta certa: "tá, mas e se eu quiser buscar digitando uma palavra?" 😄
Pois é exatamente isso hoje, em Node.js. No fim deste artigo você vai digitar "computador com memória DDR5 até R$ 2.000 e com estoque" e receber os produtos certos, mesmo que nenhum deles tenha essas palavras escritas exatamente assim.
🧩 A peça que faltava
Vamos começar pelo erro, porque ele ensina rápido. Se você mandar texto direto para o Qdrant, é isso que volta:
{
    "status": {
        "error": "Format error in JSON body: data did not match any variant of untagged enum NamedVectorStruct at line 1 column 39"
    },
    "time": 0
}
Ele não entende palavra nenhuma. O Qdrant guarda e compara números, e só. Quem traduz a sua frase em números é outra coisa, que vive fora do banco:
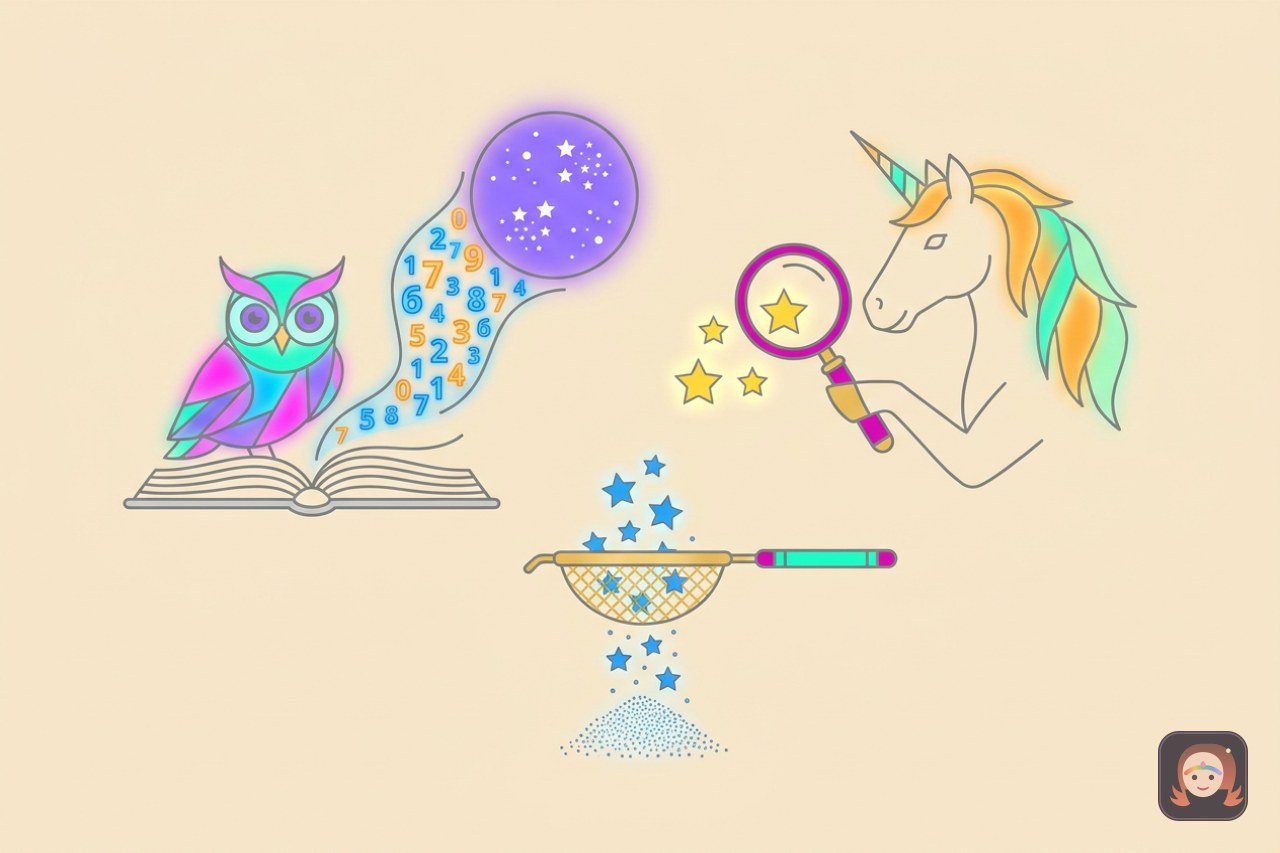
Esse tal modelo de embeddings é uma IA pequena, treinada para uma tarefa só: ler um texto e devolver uma lista de números que representa o sentido dele. Textos com sentido parecido ganham números parecidos. É essa a mágica toda. ✨
E veja a frase embaixo do desenho, porque ela é a regra que não perdoa: o modelo da busca tem de ser o mesmo que gerou os vetores gravados. É como uma régua. Se você mediu o acervo em centímetros, não adianta consultar em polegadas: os números chegam, a busca responde, e o resultado é lixo silencioso.
💸 "Vou ter que pagar uma API de IA?"
Não. E essa é a melhor notícia deste artigo.
Dá para rodar o modelo no seu próprio servidor, de graça, com o Transformers.js. Ele roda modelos abertos direto no Node, sem chave de API e sem cobrança por busca.
Se o seu servidor ainda não tem Node, instale primeiro:
curl -fsSL https://deb.nodesource.com/setup_22.x -o node.sh
bash node.sh
apt install -y nodejs

node --version
Depois, crie a pasta do projeto e instale as duas bibliotecas:
mkdir -p /opt/qdrant/node
cd /opt/qdrant/node
npm init -y

npm install @xenova/transformers @qdrant/js-client-rest
São só essas duas: uma gera os vetores, a outra conversa com o Qdrant.
🌎 Escolhendo um modelo que fale português
Aqui mora a primeira armadilha, e ela é fácil de cair porque nada avisa. A maioria dos modelos populares só entende inglês. Se você usar um deles, a busca em português responde, não dá erro, e simplesmente traz resultado ruim.
O que eu uso é este, que é multilíngue e leve:
const MODELO = "Xenova/paraphrase-multilingual-MiniLM-L12-v2";
const TAMANHO = 384;
O nome dele conta tudo: multilingual (fala português), MiniLM (é a versão pequena) e L12 (doze camadas). Ele devolve 384 números por frase, e ocupa cerca de 130 MB em disco.
Se não tem "multilingual" no nome, desconfie antes de gravar mil registros com a régua errada. 🙂
🗂️ A coleção nova, com o tamanho certo
Lembra que o tamanho do vetor é decidido na criação da coleção e não muda depois? Então a coleção do artigo passado (de 4 números) não serve: o modelo devolve 384, e os dois números têm de bater.
Vamos criar uma coleção nova, agora com produtos de loja, que é onde isso fica útil de verdade:
const PRODUTOS = [
    { nome: "PC Gamer Ryzen 7 com 32GB DDR5 e RTX 4060", preco: 6500, estoque: 4, categoria: "computador" },
    { nome: "PC Gamer Ryzen 5 com 16GB DDR5 e RTX 3050", preco: 1950, estoque: 7, categoria: "computador" },
    { nome: "Computador basico Intel i3 com 8GB DDR4", preco: 1750, estoque: 0, categoria: "computador" },
    { nome: "Computador escritorio Intel i5 com 16GB DDR5", preco: 1890, estoque: 3, categoria: "computador" },
    { nome: "Notebook Dell i5 com 16GB DDR5 tela 15 polegadas", preco: 3400, estoque: 2, categoria: "computador" },
    { nome: "Notebook Acer Celeron com 4GB DDR4", preco: 1600, estoque: 5, categoria: "computador" },
    { nome: "Cadeira gamer reclinavel com apoio lombar", preco: 900, estoque: 12, categoria: "movel" },
    { nome: "Monitor 27 polegadas 144Hz para jogos", preco: 1400, estoque: 6, categoria: "monitor" }
];
Repare que só o nome vira vetor. O preço, o estoque e a categoria vão no payload, que é a parte "banco de dados normal" de cada ponto. Guarde isso, porque é dela que sai o filtro daqui a pouco.
A função que gera o vetor é de três linhas:
async function gerarVetor(modelo, texto) {
    // O pooling "mean" junta os numeros de cada palavra num vetor so da frase.
    const saida = await modelo(texto, { pooling: "mean", normalize: true });
    return Array.from(saida.data);
}
Aquele Array.from não é enfeite. O Transformers.js devolve um Float32Array, que é um tipo especial do JavaScript para números, e o Qdrant espera um array comum. Sem a conversão, o que chega no banco é um objeto esquisito em vez da lista, e o erro que aparece depois não ajuda em nada.
E a gravação:
async function criarColecao(cliente, modelo) {
    const existe = await cliente.collectionExists(COLECAO);
    if (existe.exists) {
        await cliente.deleteCollection(COLECAO);
    }

    await cliente.createCollection(COLECAO, {
        vectors: { size: TAMANHO, distance: "Cosine" }
    });

    const pontos = [];
    for (let i = 0; i < PRODUTOS.length; i++) {
        const produto = PRODUTOS[i];
        const vetor = await gerarVetor(modelo, produto.nome);

        pontos.push({
            id: i + 1,
            vector: vetor,
            payload: {
                nome: produto.nome,
                preco: produto.preco,
                categoria: produto.categoria,
                // Guardo um campo pronto de sim/nao: filtrar por ele e mais
                // simples do que perguntar "estoque maior que zero" toda vez.
                tem_estoque: produto.estoque > 0,
                estoque: produto.estoque
            }
        });
    }

    // O wait: true faz o Qdrant so responder depois de gravar de verdade.
    await cliente.upsert(COLECAO, { wait: true, points: pontos });
    console.log("Colecao criada com " + pontos.length + " produtos.");
}
O tem_estoque merece uma palavra. Eu poderia filtrar por "estoque maior que zero" toda vez, mas guardar um campo pronto de sim/não deixa o filtro mais simples de escrever e de ler. Dado calculado uma vez na gravação é dado que ninguém erra na consulta.
Rodando, a coleção nasce com os oito produtos. No painel, o ponto 1 mostra os dois lados: o payload em cima, o vetor embaixo.
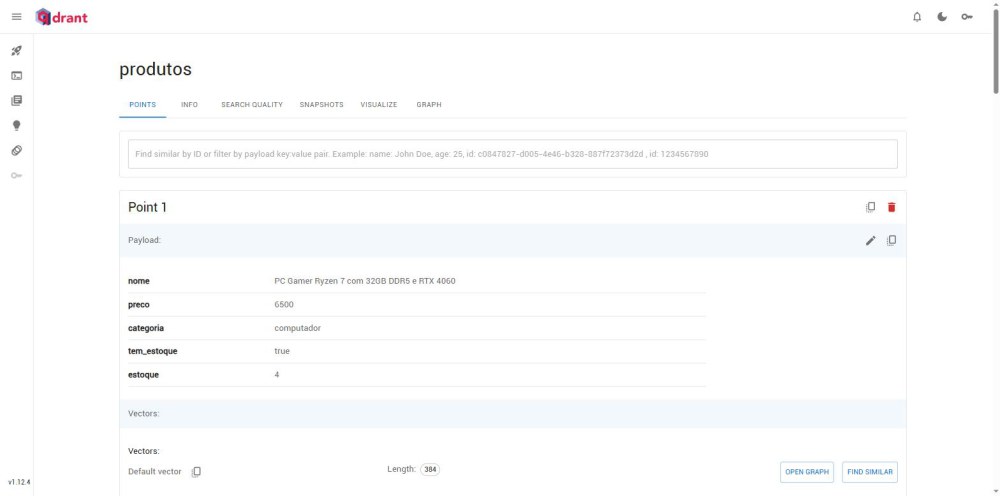
Olhe o Length: 384 lá no rodapé. Aqueles 384 números foram gerados a partir da frase "PC Gamer Ryzen 7 com 32GB DDR5 e RTX 4060", e é neles que a busca acontece. O que está em cima, na tabela, é só o que vai voltar junto na resposta.
🔍 A primeira busca por texto
A busca é a mesma coisa ao contrário: pega a frase que a pessoa digitou, gera o vetor com o mesmo modelo, e pergunta ao Qdrant quem se parece.
const vetor = await gerarVetor(modelo, frase);

const resposta = await cliente.query(COLECAO, {
    query: vetor,
    limit: 3,
    with_payload: true
});

for (const item of resposta.points) {
    const nota = Math.round(item.score * 100);
    console.log(nota + "%  " + item.payload.nome);
}
Buscando por "computador com memória ddr5":
72%  Computador escritorio Intel i5 com 16GB DDR5  |  R$ 1890  |  estoque 3
66%  Computador basico Intel i3 com 8GB DDR4       |  R$ 1750  |  estoque 0
63%  Notebook Acer Celeron com 4GB DDR4            |  R$ 1600  |  estoque 5
Repare no notebook Acer na terceira posição. Ele apareceu numa busca por "computador" sem ter a palavra computador no nome. Um LIKE '%computador%' do SQL não o traria nunca, e o modelo trouxe porque sabe que notebook é um computador. É esse o ganho todo. 🎯
Mas repare também no problema: o segundo resultado é um DDR4 (eu pedi DDR5) e está sem estoque. É aqui que entra a parte que resolve.
🎛️ Semelhança e filtro na mesma consulta
O pedido de verdade quase nunca é só "parecido com isto". É "parecido com isto, até tanto, e que eu possa comprar hoje". No Qdrant, isso vai no mesmo pedido:
function montarFiltro(precoMaximo, somenteEstoque, categoria) {
    const condicoes = [];

    if (precoMaximo !== null) {
        // lte quer dizer "menor ou igual" (less than or equal).
        condicoes.push({ key: "preco", range: { lte: precoMaximo } });
    }

    if (somenteEstoque) {
        condicoes.push({ key: "tem_estoque", match: { value: true } });
    }

    if (categoria !== null) {
        condicoes.push({ key: "categoria", match: { value: categoria } });
    }

    if (condicoes.length === 0) {
        return undefined;
    }

    // must = todas as condicoes precisam valer, como o AND do SQL.
    return { must: condicoes };
}
São três tipos de condição, e vale saber a diferença: range compara número (lte é "menor ou igual", gte é "maior ou igual") e match compara valor exato, que serve para texto e para sim/não. O must junta tudo como o AND do SQL.
Repare no return undefined quando não há condição nenhuma. É de propósito: mandar um filtro vazio para o Qdrant é diferente de não mandar filtro, e o undefined faz a biblioteca simplesmente omitir o campo do pedido.
O filtro entra na consulta pelo campo filter:
const resposta = await cliente.query(COLECAO, {
    query: vetor,
    filter: montarFiltro(precoMaximo, somenteEstoque, categoria),
    limit: 3,
    with_payload: true
});
E agora a mesma busca de antes, com teto de R$ 2.000 e só o que tem estoque:
Busca: computador com memoria ddr5
Preco maximo: R$ 2000
Somente com estoque

72%  Computador escritorio Intel i5 com 16GB DDR5  |  R$ 1890  |  estoque 3
63%  Notebook Acer Celeron com 4GB DDR4            |  R$ 1600  |  estoque 5
57%  PC Gamer Ryzen 5 com 16GB DDR5 e RTX 3050     |  R$ 1950  |  estoque 7
O i3 sem estoque sumiu, nada acima de R$ 2.000 entrou, e o PC Gamer de R$ 1.950 subiu para o lugar vago. 🎉
⚡ Por que o filtro ir junto muda tudo
Esse é o detalhe técnico que faz diferença de verdade, e é o motivo de eu preferir esse banco a improvisar com uma busca comum.
O Qdrant aplica o filtro durante a busca, não depois. Parece detalhe, mas compare os dois jeitos:
filtrando DEPOIS   ->  pega os 3 mais parecidos  ->  joga fora os sem estoque  ->  sobrou 1
filtrando JUNTO    ->  pega os 3 mais parecidos QUE TEM estoque              ->  sobraram 3
Filtrando depois, você pede três resultados e pode receber zero, mesmo existindo dez produtos perfeitos no catálogo. E o pior: isso acontece justamente quando o filtro é apertado, que é quando a busca mais importa.
Testei o caso extremo, com teto de R$ 800:
Busca: computador ddr5
Preco maximo: R$ 800
Somente com estoque

Nada encontrado com esses filtros.
Aí não tem jeito mesmo: nenhum computador custa menos que isso na lista. Mas repare que a resposta é limpa e imediata, não um erro.
😅 A cadeira gamer que se achou um computador
Agora a parte que eu mais gosto de contar, porque foi um resultado que me fez rir sozinha na frente do terminal.
Busquei por "computador para jogos", esperando os dois PCs Gamer no topo. Veio isto:
61%  Cadeira gamer reclinavel com apoio lombar  |  R$ 900   |  estoque 12
53%  PC Gamer Ryzen 5 com 16GB DDR5 e RTX 3050  |  R$ 1950  |  estoque 7
52%  Monitor 27 polegadas 144Hz para jogos      |  R$ 1400  |  estoque 6
A cadeira em primeiro lugar. Com folga. 🪑😂
E o modelo não está exatamente errado: ele viu "gamer", viu "jogos", e concluiu que aquilo tem tudo a ver com o pedido. O que ele não sabe é que cadeira não é computador. Modelo pequeno confunde o produto com o acessório do mesmo assunto, e isso não é bug: é o limite de um modelo de 130 MB.
O que me interessa aqui é que nenhuma reescrita da consulta resolve isso. Você pode digitar "computador para jogos potente", "PC gamer", "máquina para jogar": enquanto a cadeira tiver "gamer" no nome, ela vai continuar aparecendo por perto.
A saída é a categoria que a gente guardou lá no payload:
Busca: computador para jogos
Categoria: computador

53%  PC Gamer Ryzen 5 com 16GB DDR5 e RTX 3050     |  R$ 1950  |  estoque 7
50%  PC Gamer Ryzen 7 com 32GB DDR5 e RTX 4060     |  R$ 6500  |  estoque 4
44%  Computador escritorio Intel i5 com 16GB DDR5  |  R$ 1890  |  estoque 3
Os dois PCs Gamer no topo, e a cadeira fora da lista. 😌
Guarde essa lição, porque ela vale para qualquer projeto com busca semântica: o filtro não é só um refinamento, é a rédea do modelo. A semelhança é boa achando coisa parecida e péssima entendendo que categorias existem. Uma faz o trabalho da outra: o vetor traz o que se parece, o filtro garante que é do tipo certo.
🗺️ Vendo os vetores no mapa
O painel tem uma aba que ajuda a enxergar isso. Em Visualize, rode:
{
    "limit": 20,
    "color_by": {
        "payload": "categoria"
    }
}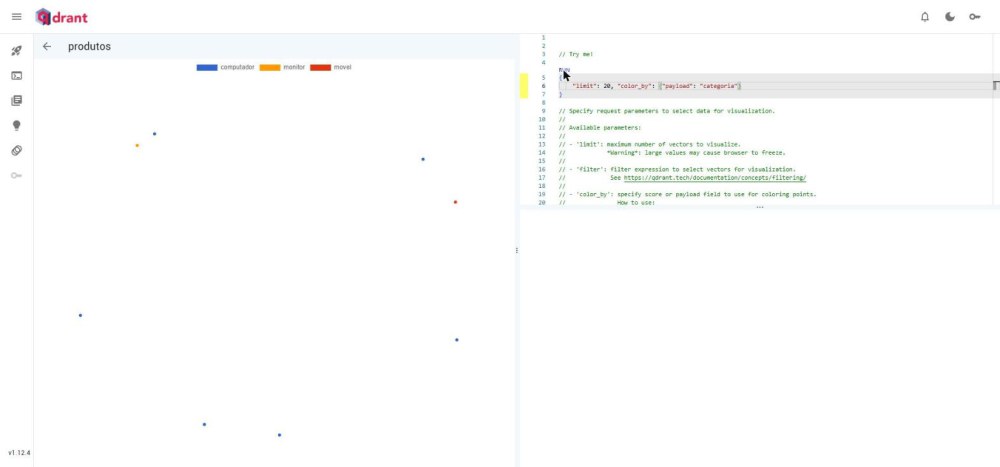
Ele achata os 384 números em duas dimensões para caber na tela, então não leve a posição ao pé da letra. Mas dá para ver os computadores (azul) espalhados de um jeito, e o móvel (vermelho) e o monitor (laranja) em cantos próprios. Com poucos pontos fica esparso; com milhares, os grupos aparecem sozinhos.
⏱️ Quanto tempo cada parte leva
Uma dúvida justa é se colocar uma IA no meio do caminho não deixa tudo lento. Medi as três etapas separadas:
carregar o modelo : 5.87 s
gerar o vetor     : 0.039 s
buscar no qdrant  : 0.218 s
Os quase 6 segundos são de carregar o modelo na memória, e isso acontece uma vez só, quando o programa sobe. É por isso que o script cria o modelo no começo e reaproveita: fazer isso a cada busca seria jogar 6 segundos fora por consulta. Num servidor web, você carrega uma vez e atende todas as requisições com o mesmo modelo.
O que acontece a cada busca são os outros dois números. Rodando quatro buscas seguidas:
computador para jogos    vetor 39 ms   busca 218 ms
notebook barato          vetor 25 ms   busca  62 ms
cadeira confortavel      vetor 15 ms   busca  20 ms
monitor grande           vetor 14 ms   busca  47 ms
Cerca de 20 ms para gerar o vetor, na CPU de uma VPS comum, sem placa de vídeo. A busca em si cai conforme o Qdrant esquenta os caches. Somando, é uma busca completa em bem menos de um décimo de segundo. 🚀
🕳️ O modelo que some no próximo deploy
Essa eu descobri fuçando o disco, e ela morde depois, quando você já esqueceu que existia.
O Transformers.js guarda o modelo dentro do node_modules por padrão. E o node_modules é justamente a pasta que some a cada instalação limpa, a cada deploy novo, a cada rm -rf node_modules que a gente dá quando algo quebra.
Resultado: 130 MB baixados de novo, e a primeira busca depois disso trava enquanto espera. Num servidor com internet lenta, é o suficiente para alguém achar que o sistema morreu.
A correção são duas linhas, e elas vêm antes de qualquer uso da biblioteca:
const { pipeline, env } = require("@xenova/transformers");

// Sem isto o modelo vai parar dentro do node_modules, e sao 130 MB
// baixados de novo a cada instalacao limpa.
env.cacheDir = "/opt/qdrant/modelos-js";
Pasta fixa, fora do node_modules, que sobrevive a deploy. 👍
🤖 Isto aqui é RAG?
Essa pergunta apareceu assim que mostrei o resultado funcionando, e a resposta é: quase. 😄
RAG é a sigla de Retrieval Augmented Generation, e ela tem três partes. O que a gente fez hoje é a primeira, inteira:
R  Retrieval    buscar os trechos relevantes       <- e isto que o artigo faz
A  Augmented    enfiar os trechos no prompt
G  Generation   um LLM escrever a resposta em texto
Repare na diferença do que sai de cada um. O nosso script devolve uma lista, com nota de semelhança:
72%  Computador escritorio Intel i5 com 16GB DDR5  |  R$ 1890  |  estoque 3
63%  Notebook Acer Celeron com 4GB DDR4            |  R$ 1600  |  estoque 5
Um RAG pegaria essa mesma lista, mandaria para um modelo de linguagem junto da pergunta original, e devolveria uma frase: "para até R$ 2.000 com DDR5, o mais indicado é o Intel i5 de 16GB, por R$ 1.890, que está em estoque".
Ou seja: o RAG não substitui o que você acabou de montar, ele se apoia nele. E olha que a parte trabalhosa é justamente esta, a da busca: escolher o modelo certo, acertar o tamanho do vetor, guardar o payload, fazer o filtro andar junto. O pedaço que falta, mandar o resultado para um LLM, é bem menor que este artigo inteiro.
RAG na prática: o Qdrant respondendo com a OpenAIAs duas letras que faltam, em umas 40 linhas de Node.js sobre esta busca. Com a prova do que acontece quando o modelo não é instruído a não inventar.blog.palomamacetko.com.br📜 O script inteiro
É um arquivo só, que cria a coleção quando você o roda sem argumentos e busca quando você passa uma frase:
const { pipeline, env } = require("@xenova/transformers");
const { QdrantClient } = require("@qdrant/js-client-rest");

// Sem isto o modelo vai parar numa pasta temporaria que o Linux limpa ao
// reiniciar, e sao 130 MB baixados de novo na primeira busca do dia.
env.cacheDir = "/opt/qdrant/modelos-js";

const ENDERECO = "http://localhost:6333";
const CHAVE = "SUA_CHAVE_AQUI";
const COLECAO = "produtos";

// Precisa entender portugues, entao o modelo tem de ser multilingue.
// Ele gera 384 numeros por frase, e a colecao tem de usar esse mesmo tamanho.
const MODELO = "Xenova/paraphrase-multilingual-MiniLM-L12-v2";
const TAMANHO = 384;

const PRODUTOS = [
    { nome: "PC Gamer Ryzen 7 com 32GB DDR5 e RTX 4060", preco: 6500, estoque: 4, categoria: "computador" },
    { nome: "PC Gamer Ryzen 5 com 16GB DDR5 e RTX 3050", preco: 1950, estoque: 7, categoria: "computador" },
    { nome: "Computador basico Intel i3 com 8GB DDR4", preco: 1750, estoque: 0, categoria: "computador" },
    { nome: "Computador escritorio Intel i5 com 16GB DDR5", preco: 1890, estoque: 3, categoria: "computador" },
    { nome: "Notebook Dell i5 com 16GB DDR5 tela 15 polegadas", preco: 3400, estoque: 2, categoria: "computador" },
    { nome: "Notebook Acer Celeron com 4GB DDR4", preco: 1600, estoque: 5, categoria: "computador" },
    { nome: "Cadeira gamer reclinavel com apoio lombar", preco: 900, estoque: 12, categoria: "movel" },
    { nome: "Monitor 27 polegadas 144Hz para jogos", preco: 1400, estoque: 6, categoria: "monitor" }
];

async function gerarVetor(modelo, texto) {
    // O pooling "mean" junta os numeros de cada palavra num vetor so da frase.
    const saida = await modelo(texto, { pooling: "mean", normalize: true });
    return Array.from(saida.data);
}

async function criarColecao(cliente, modelo) {
    const existe = await cliente.collectionExists(COLECAO);
    if (existe.exists) {
        await cliente.deleteCollection(COLECAO);
    }

    await cliente.createCollection(COLECAO, {
        vectors: { size: TAMANHO, distance: "Cosine" }
    });

    const pontos = [];
    for (let i = 0; i < PRODUTOS.length; i++) {
        const produto = PRODUTOS[i];
        const vetor = await gerarVetor(modelo, produto.nome);

        pontos.push({
            id: i + 1,
            vector: vetor,
            payload: {
                nome: produto.nome,
                preco: produto.preco,
                // A categoria salva a busca quando o modelo se confunde:
                // "computador para jogos" traz a cadeira gamer em primeiro.
                categoria: produto.categoria,
                // Guardo um campo pronto de sim/nao: filtrar por ele e mais
                // simples do que perguntar "estoque maior que zero" toda vez.
                tem_estoque: produto.estoque > 0,
                estoque: produto.estoque
            }
        });
    }

    // O wait: true faz o Qdrant so responder depois de gravar de verdade.
    await cliente.upsert(COLECAO, { wait: true, points: pontos });
    console.log("Colecao criada com " + pontos.length + " produtos.");
}

function montarFiltro(precoMaximo, somenteEstoque, categoria) {
    const condicoes = [];

    if (precoMaximo !== null) {
        // lte quer dizer "menor ou igual" (less than or equal).
        condicoes.push({ key: "preco", range: { lte: precoMaximo } });
    }

    if (somenteEstoque) {
        condicoes.push({ key: "tem_estoque", match: { value: true } });
    }

    if (categoria !== null) {
        condicoes.push({ key: "categoria", match: { value: categoria } });
    }

    if (condicoes.length === 0) {
        return undefined;
    }

    // must = todas as condicoes precisam valer, como o AND do SQL.
    return { must: condicoes };
}

async function buscar(cliente, modelo, frase, precoMaximo, somenteEstoque, categoria) {
    const vetor = await gerarVetor(modelo, frase);

    const resposta = await cliente.query(COLECAO, {
        query: vetor,
        filter: montarFiltro(precoMaximo, somenteEstoque, categoria),
        limit: 3,
        with_payload: true
    });

    console.log("");
    console.log("Busca: " + frase);
    if (precoMaximo !== null) {
        console.log("Preco maximo: R$ " + precoMaximo);
    }
    if (somenteEstoque) {
        console.log("Somente com estoque");
    }
    if (categoria !== null) {
        console.log("Categoria: " + categoria);
    }
    console.log("");

    if (resposta.points.length === 0) {
        console.log("Nada encontrado com esses filtros.");
        console.log("");
        return;
    }

    for (const item of resposta.points) {
        const nota = Math.round(item.score * 100);
        const dados = item.payload;
        console.log(
            nota + "%  " + dados.nome +
            "  |  R$ " + dados.preco +
            "  |  estoque " + dados.estoque
        );
    }
    console.log("");
}

async function main() {
    const modelo = await pipeline("feature-extraction", MODELO);
    const cliente = new QdrantClient({ url: ENDERECO, apiKey: CHAVE });

    const argumentos = process.argv.slice(2);

    if (argumentos.length === 0) {
        await criarColecao(cliente, modelo);
        return;
    }

    const frase = argumentos[0];
    let precoMaximo = null;
    let somenteEstoque = false;
    let categoria = null;

    if (argumentos.length > 1) {
        precoMaximo = Number(argumentos[1]);
    }

    if (argumentos.length > 2 && argumentos[2] === "estoque") {
        somenteEstoque = true;
    }

    if (argumentos.length > 3) {
        categoria = argumentos[3];
    }

    await buscar(cliente, modelo, frase, precoMaximo, somenteEstoque, categoria);
}

main();
Salve como buscar.js em /opt/qdrant/node, troque a CHAVE pela sua, e use assim:
cd /opt/qdrant/node

node buscar.js                                      # cria a colecao
node buscar.js "computador ddr5"                    # busca
node buscar.js "computador ddr5" 2000               # ate R$ 2000
node buscar.js "computador ddr5" 2000 estoque       # e com estoque
node buscar.js "para jogos" 9999 estoque computador # so computadores
Na primeira vez ele demora um pouco a mais, porque está baixando o modelo. Depois disso, é instantâneo.
Por hoje é só, meus unicórnios! 🦄✨
Que a magia do arco-íris continue brilhando em suas vidas! Até mais! 🌈🌟
Perguntas frequentes
Como buscar por texto no Qdrant?
Preciso pagar uma API de IA para gerar os embeddings?
Dá para filtrar por preço e estoque junto com a busca por semelhança?
filter, e o Qdrant o aplica durante a busca, não depois. Isso importa: se filtrasse depois, você pediria 3 resultados, ele traria os 3 mais parecidos e o filtro poderia derrubar todos, sobrando zero.Por que a busca por "computador para jogos" trouxe uma cadeira gamer?
Busca semântica com banco vetorial é a mesma coisa que RAG?
Qual biblioteca usar para gerar embeddings em Node.js?
@xenova/transformers), que roda modelos abertos direto no Node. O FastEmbed também tem versão para Node, mas o único modelo multilíngue dele é grande: nesta VPS ele levou 4 a 7 segundos por vetor, contra cerca de 20 ms do Transformers.js com um modelo leve.Por que o modelo é baixado de novo depois de reinstalar as dependências?
node_modules por padrão, e essa pasta some a cada npm install limpo ou deploy novo. São 130 MB baixados outra vez, e num servidor com internet lenta isso trava a primeira requisição. Resolve-se apontando o cache para uma pasta fixa com env.cacheDir.Leia também
API Mágica: CEP e Pix de graça, sem cartão
Lancei a API Mágica: CEP, QR Code Pix, geradores e mais, de graça. Veja como consultar e gerar com Node.js em poucas linhas.
Resend: enviando e recebendo e-mails com Node.js
Tutorial da Resend com Node.js: criar a chave, enviar com fetch, verificar o domínio e receber e-mails por webhook conferindo a assinatura.
Node.js: testando scripts de scraping no ScrapingCourse
O ScrapingCourse é um site feito para treinar scraping. Cinco desafios dele em Node.js, e a armadilha real que cada um esconde.