
RAG na prática: o Qdrant respondendo com a OpenAI
Olá meus Unicórnios! 🦄✨
Nos dois artigos anteriores a gente instalou o Qdrant e fez ele buscar por significado. No fim do segundo, veio a pergunta que eu sabia que ia vir: "isso que a gente fez é RAG?"
A resposta era "quase". Hoje a gente fecha o ciclo: no fim deste artigo, você pergunta "quero um pc para jogos até 2000 reais" e recebe uma frase escrita, com o produto certo e o preço certo, em vez de uma lista de resultados. 🎯
Antes deste: busca semântica no QdrantA coleção de produtos e o código de busca que este artigo reaproveita inteiro.blog.palomamacetko.com.br⚖️ A mesma pergunta, de quatro jeitos
Antes de qualquer código, olha o que está em jogo. Um cliente digita "quero um pc para jogos até 2000 reais" na busca do seu site. Eu rodei essa mesma frase em quatro cenários, com os mesmos oito produtos cadastrados.
1️⃣ Só MySQL, com LIKE
SELECT * FROM produtos
WHERE nome LIKE '%pc para jogos%'
Empty set (0,00 sec)
Zero resultados, com dois PCs Gamer no catálogo. O LIKE procura a frase literal, e ninguém cadastra produto com o nome "pc para jogos".
2️⃣ Qdrant, sem nenhuma IA na resposta
busca por semelhança + filtro
53% PC Gamer Ryzen 5 · R$ 1950
52% PC Gamer Ryzen 7 · R$ 6500
44% Computador escritório i5 · R$ 1890
Achou os produtos certos, sem a frase bater. Mas devolve uma lista, e é o cliente que compara preço e decide.
3️⃣ Só o GPT, sem os seus dados
quero um pc para jogos ate 2000 reais
Para um PC de jogos até 2000 reais, recomendo focar em um modelo com um bom processador e uma placa de vídeo dedicada. Você pode considerar montar um PC com peças usadas.
Conselho de revista. Não cita nenhum produto seu, nenhum preço, e manda o cliente montar o próprio PC.
4️⃣ RAG: Qdrant + GPT
quero um pc para jogos ate 2000 reais
Temos o PC Gamer Ryzen 5 com 16GB DDR5 e RTX 3050 por R$ 1950. Ele é uma ótima opção para jogos dentro do seu orçamento. Temos 7 unidades em estoque.
Produto real, preço real, estoque real, numa frase pronta. E o PC de R$ 6.500 ficou de fora porque o cliente disse "até 2000".
Repare que os quatro cenários são dois problemas diferentes, e cada metade resolve um:
1 -> 2   o banco passa a ENTENDER a pergunta   (e o artigo anterior)
2 -> 4   a resposta passa a ser uma FRASE       (e este artigo)
🔤 Por que o LIKE não dá conta
Vale insistir no primeiro caso, porque é dele que a maioria dos sites ainda vive. Rodei três buscas no MySQL, com os mesmos produtos:
mysql> SELECT nome FROM produtos WHERE nome LIKE '%computador%';
+----------------------------------------------+
| Computador basico Intel i3 com 8GB DDR4      |
| Computador escritorio Intel i5 com 16GB DDR5 |
+----------------------------------------------+
2 rows in set

mysql> SELECT nome FROM produtos WHERE nome LIKE '%pc para jogos%';
Empty set

mysql> SELECT nome FROM produtos WHERE nome LIKE '%quem passa o dia sentado%';
Empty set
Na primeira, ele achou dois de oito. Ficaram de fora os dois PCs Gamer e os dois notebooks, que são computadores tanto quanto os outros: só não têm essa palavra escrita no nome.
As outras duas devolveram nada. E o problema nem é o banco: é que o cliente descreve o que quer ("pc para jogos", "cadeira para quem passa o dia sentado") e o cadastro tem o que o produto é. O LIKE compara letra por letra e não faz essa ponte.
🤥 E quando o GPT responde sozinho
O terceiro cenário parece inofensivo, um conselho meio vago. Mas fica ruim quando a pergunta é específica. Perguntei o preço, ainda sem RAG:
Pergunta: quanto custa o pc gamer de voces e tem em estoque?

RESPOSTA (sem RAG):
O preco do PC gamer varia conforme a configuracao, mas geralmente fica entre
R$ 3.000 e R$ 10.000. Temos algumas opcoes em estoque, mas e bom verificar a
disponibilidade especifica.
Ele chutou uma faixa de R$ 3.000 a R$ 10.000 para um PC que custa R$ 1.950, e ainda garantiu que "temos algumas opções em estoque" sem ter a menor ideia do seu estoque. 😰
Não é maldade do modelo: ele nunca viu o seu catálogo, e foi treinado para ser prestativo. Sem dados, prestativo vira inventar. É esse o problema que o RAG resolve.
🧠 O que RAG quer dizer, sem enrolação
RAG é Retrieval Augmented Generation: geração aumentada por busca. Traduzindo para o que acontece de verdade:
R  Retrieval    buscar os dados certos na SUA base
A  Augmented    colocar esses dados no prompt
G  Generation   o modelo escrever a resposta usando eles
A pergunta óbvia é: por que não perguntar direto ao ChatGPT? Porque ele não faz ideia de quais produtos você vende, quanto custam nem o que tem em estoque. Nada disso estava no treinamento dele, e não vai estar nunca.
E quando um modelo de linguagem não sabe, ele raramente diz "não sei". Ele escreve algo plausível, que é bem pior. Você vai ver isso acontecer neste artigo, com um exemplo real. 😅
🔄 O caminho completo, desenhado
São cinco etapas, e as três primeiras você já montou no artigo passado:
Leia de novo a última linha do desenho, porque ela é a regra que manda em tudo: o que a busca não achar, o modelo não vai saber. Um RAG nunca é melhor que a busca que o alimenta, e é por isso que o artigo anterior é o trabalhoso, não este.
🔑 A chave da OpenAI, e onde ela não pode ficar
Você vai precisar de uma chave da OpenAI, criada no painel deles. E ela não entra no código, nunca:
// A chave NUNCA fica escrita no arquivo: ela vem do ambiente.
const CHAVE_OPENAI = process.env.OPENAI_API_KEY;
Para rodar, você passa a chave na hora:
OPENAI_API_KEY="sua-chave" node perguntar.js "quero um pc para jogos"Ou guarda num arquivo .env e coloca ele no .gitignore. Chave escrita direto no código vaza no primeiro git push, e o pior é que ela continua no histórico do git mesmo depois de você apagá-la do arquivo. 😰
🔎 Etapa 3: a busca, com uma diferença importante
A busca é a mesma do artigo anterior, mas repare no filtro:
async function buscarProdutos(cliente, modelo, pergunta) {
    const vetor = await gerarVetor(modelo, pergunta);

    const resposta = await cliente.query(COLECAO, {
        query: vetor,
        // Sem este filtro o GPT recebe a cadeira gamer como se fosse
        // computador, e escreve com toda a confianca que ela serve.
        filter: { must: [{ key: "tem_estoque", match: { value: true } }] },
        limit: 3,
        with_payload: true
    });

    return resposta.points;
}
Aquele comentário não é exagero. No artigo passado, a busca por "computador para jogos" trouxe uma cadeira gamer em primeiro lugar, porque o modelo viu "gamer" e achou parecido.
Numa lista de resultados, isso é engraçado: você vê a cadeira, ri, e ignora. Num RAG, é diferente: aquela cadeira entra no prompt como se fosse um produto válido, e o modelo pode recomendá-la de cara séria. O filtro deixa de ser refinamento e vira proteção.
📝 Etapa 4: transformar o resultado em texto
O Qdrant devolve objetos JSON, e o modelo lê texto. Essa função faz a ponte, e ela é bem mais simples do que parece:
function montarContexto(produtos) {
    const linhas = [];
    for (const item of produtos) {
        const d = item.payload;
        linhas.push("- " + d.nome + " | R$ " + d.preco + " | estoque: " + d.estoque);
    }
    return linhas.join("\n");
}
O resultado é uma listinha em texto puro:
- PC Gamer Ryzen 5 com 16GB DDR5 e RTX 3050 | R$ 1950 | estoque: 7
- PC Gamer Ryzen 7 com 32GB DDR5 e RTX 4060 | R$ 6500 | estoque: 4
- Cadeira gamer reclinavel com apoio lombar | R$ 900 | estoque: 12
Repare que eu não mando o JSON cru nem os 384 números do vetor. O modelo não precisa deles, e cada caractere enviado é token pago. Texto limpo e curto sai mais barato e é melhor entendido.
💬 Etapa 5: a instrução que segura o modelo
Aqui está a parte mais importante do artigo inteiro. A conversa com o GPT tem duas mensagens: a system, que diz como ele deve se comportar, e a user, que leva os dados e a pergunta.
const instrucao =
    "Voce e o atendente de uma loja de informatica. " +
    "Responda em portugues, em no maximo 3 frases, usando SOMENTE os produtos da lista. " +
    "Cite o preco. Se nenhum servir, diga que nao encontrou e nao invente produto.";

const conteudo =
    "Produtos disponiveis:\n" + contexto + "\n\nPergunta do cliente: " + pergunta;
E a chamada, com fetch, que já vem pronto no Node moderno (não precisa instalar nada):
const resposta = await fetch("https://api.openai.com/v1/chat/completions", {
    method: "POST",
    headers: {
        "Authorization": "Bearer " + CHAVE_OPENAI,
        "Content-Type": "application/json"
    },
    body: JSON.stringify({
        model: MODELO_GPT,
        messages: [
            { role: "system", content: instrucao },
            { role: "user", content: conteudo }
        ],
        // Temperatura baixa deixa a resposta mais previsivel e menos
        // criativa, que e o que se quer quando ela fala de preco.
        temperature: 0.2
    })
});

if (!resposta.ok) {
    const erro = await resposta.text();
    throw new Error("A OpenAI recusou: " + resposta.status + " " + erro);
}
Aquele if (!resposta.ok) é obrigatório e muita gente esquece. O fetch não lança erro quando a API responde 401 ou 429: ele devolve a resposta normalmente, com o erro dentro. Sem essa checagem, o programa segue em frente e quebra três linhas depois, com uma mensagem que não ajuda em nada.
🗣️ O chat funcionando
Antes do terminal, deixa eu mostrar como isso fica na pele de quem usa. Peguei as três respostas que o script me deu e coloquei numa tela de conversa, que é onde esse código costuma acabar:
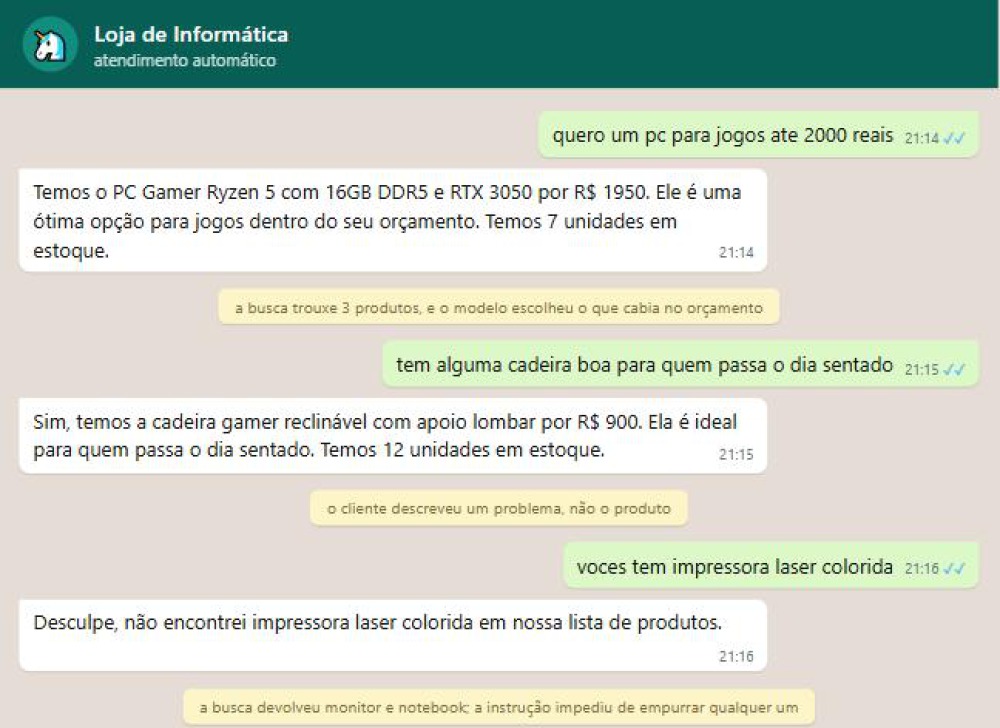
As três respostas em branco são exatamente as que o GPT devolveu, sem nenhum retoque meu. As tarjas amarelas são comentários que eu acrescentei para você ver o que aconteceu por baixo de cada uma.
Agora o mesmo no terminal, com o meio de campo aparecendo. Três perguntas, três comportamentos diferentes.
A primeira, o caso feliz:
$ node perguntar.js "quero um pc para jogos ate 2000 reais"

PERGUNTA: quero um pc para jogos ate 2000 reais

O QUE A BUSCA ACHOU:
- PC Gamer Ryzen 5 com 16GB DDR5 e RTX 3050 | R$ 1950 | estoque: 7
- PC Gamer Ryzen 7 com 32GB DDR5 e RTX 4060 | R$ 6500 | estoque: 4
- Cadeira gamer reclinavel com apoio lombar | R$ 900 | estoque: 12

RESPOSTA DO GPT:
Temos o PC Gamer Ryzen 5 com 16GB DDR5 e RTX 3050 por R$ 1950. Ele e uma
otima opcao para jogos dentro do seu orcamento. Temos 7 unidades em estoque.

tokens: 164 entrada + 45 saida
Repare em duas coisas boas aí. O modelo ignorou o PC de R$ 6.500, porque o cliente disse "até 2000". E ignorou também a cadeira gamer, que a busca insistiu em trazer. 😄
Só que isso foi sorte do modelo ser bom, não garantia. É por isso que o filtro da etapa 3 continua importando: um dia a lista vem com algo que ele não descarta sozinho.
A segunda, mudando de assunto:
$ node perguntar.js "tem alguma cadeira boa para quem passa o dia sentado"

O QUE A BUSCA ACHOU:
- Cadeira gamer reclinavel com apoio lombar | R$ 900 | estoque: 12
- Notebook Dell i5 com 16GB DDR5 tela 15 polegadas | R$ 3400 | estoque: 2
- Notebook Acer Celeron com 4GB DDR4 | R$ 1600 | estoque: 5

RESPOSTA DO GPT:
Sim, temos a cadeira gamer reclinavel com apoio lombar por R$ 900. Ela e
ideal para quem passa o dia sentado. Temos 12 unidades em estoque.
Agora a cadeira é a resposta certa, e os notebooks é que estão sobrando. A busca traz sempre os três mais parecidos, e cabe ao modelo escolher. Note que o cliente não escreveu "cadeira gamer" nem "apoio lombar": ele descreveu um problema, e a busca por significado deu conta.
A terceira, pedindo o que não existe:
$ node perguntar.js "voces tem impressora laser colorida"

O QUE A BUSCA ACHOU:
- Monitor 27 polegadas 144Hz para jogos | R$ 1400 | estoque: 6
- Notebook Acer Celeron com 4GB DDR4 | R$ 1600 | estoque: 5
- Cadeira gamer reclinavel com apoio lombar | R$ 900 | estoque: 12

RESPOSTA DO GPT:
Desculpe, nao encontrei impressora laser colorida em nossa lista de produtos.
Essa é a mais importante das três. 🙏 A busca vetorial sempre devolve alguma coisa: ela traz os mais próximos, mesmo que "mais próximo" seja um monitor quando se pediu uma impressora. Não existe resultado vazio a menos que você filtre.
Então quem tem de dizer "não temos" é o modelo, e ele só faz isso porque a instrução mandou. Sem ela, o caminho natural dele é ser prestativo com o que tem na mão.
🤥 A prova de que a instrução importa
Aqui eu fiz o teste que fecha o argumento. Perguntei sobre um detalhe que não existe em lugar nenhum dos meus dados: garantia e fonte do PC.
Primeiro sem a instrução restritiva, com um system genérico de atendente:
Pergunta: esse pc gamer tem quantos anos de garantia e vem com qual fonte?

RESPOSTA:
Esse PC Gamer possui 1 ano de garantia e vem com uma fonte de 500W.
Se precisar de mais informacoes, estou a disposicao!
Um ano de garantia. Fonte de 500W. Nada disso existe. O único dado que eu mandei foi "PC Gamer Ryzen 5 com 16GB DDR5 e RTX 3050 | R$ 1950 | estoque: 7". Ele inventou os dois números, com a maior naturalidade, e ainda se ofereceu para ajudar mais. 😱
Agora a mesma pergunta, com a instrução mandando usar só a lista e admitir quando não souber:
Pergunta: esse pc gamer tem quantos anos de garantia e vem com qual fonte?

RESPOSTA:
Desculpe, nao tenho essa informacao sobre a garantia e a fonte do PC Gamer.
Mesma pergunta, mesmo modelo, mesmos dados. A única diferença foram duas frases no system. É por isso que eu insisto: num RAG, a instrução não é enfeite, é a parte que impede o seu atendente virtual de mentir para o cliente.
E imagine esse mesmo erro num sistema de verdade, respondendo sobre prazo de entrega, política de troca ou compatibilidade de peça. O cliente acredita, compra, e a culpa é sua. 😬
⏱️ Quanto tempo e quanto custa
Medi as três etapas separadas:
gerar o vetor    :  29 ms
buscar no qdrant :  93 ms
resposta do gpt  : 628 ms
A conta é clara: mais de 80% do tempo está na OpenAI, que é justamente a parte que você não controla. A busca inteira, que parecia a coisa complicada, custa 120 ms.
Se você for montar uma interface de chat, é isso que justifica usar resposta em stream, com o texto aparecendo aos poucos: não deixa mais rápido, mas o usuário começa a ler enquanto o resto chega.
E o custo, olhando os tokens: cada pergunta usou cerca de 160 tokens de entrada e 40 de saída no gpt-4o-mini. É fração de centavo por consulta. O que pesa em escala é a entrada, e ela cresce com o tamanho do contexto, ou seja, com quantos resultados você manda. Mandar 20 produtos em vez de 3 multiplica a conta sem melhorar a resposta.
📜 O script inteiro
Ele reaproveita a coleção produtos criada no artigo anterior, então rode aquele primeiro:
const { pipeline, env } = require("@xenova/transformers");
const { QdrantClient } = require("@qdrant/js-client-rest");

// Sem isto o modelo vai parar dentro do node_modules, e sao 130 MB
// baixados de novo a cada instalacao limpa.
env.cacheDir = "/opt/qdrant/modelos-js";

const ENDERECO = "http://localhost:6333";
const CHAVE_QDRANT = "SUA_CHAVE_AQUI";
const COLECAO = "produtos";

const MODELO_EMBEDDING = "Xenova/paraphrase-multilingual-MiniLM-L12-v2";
const MODELO_GPT = "gpt-4o-mini";

// A chave NUNCA fica escrita no arquivo: ela vem do ambiente.
const CHAVE_OPENAI = process.env.OPENAI_API_KEY;

async function gerarVetor(modelo, texto) {
    const saida = await modelo(texto, { pooling: "mean", normalize: true });
    return Array.from(saida.data);
}

async function buscarProdutos(cliente, modelo, pergunta) {
    const vetor = await gerarVetor(modelo, pergunta);

    const resposta = await cliente.query(COLECAO, {
        query: vetor,
        // Sem este filtro o GPT recebe a cadeira gamer como se fosse
        // computador, e escreve com toda a confianca que ela serve.
        filter: { must: [{ key: "tem_estoque", match: { value: true } }] },
        limit: 3,
        with_payload: true
    });

    return resposta.points;
}

function montarContexto(produtos) {
    const linhas = [];
    for (const item of produtos) {
        const d = item.payload;
        linhas.push("- " + d.nome + " | R$ " + d.preco + " | estoque: " + d.estoque);
    }
    return linhas.join("\n");
}

async function pedirResposta(pergunta, contexto) {
    const instrucao =
        "Voce e o atendente de uma loja de informatica. " +
        "Responda em portugues, em no maximo 3 frases, usando SOMENTE os produtos da lista. " +
        "Cite o preco. Se nenhum servir, diga que nao encontrou e nao invente produto.";

    const conteudo =
        "Produtos disponiveis:\n" + contexto + "\n\nPergunta do cliente: " + pergunta;

    const resposta = await fetch("https://api.openai.com/v1/chat/completions", {
        method: "POST",
        headers: {
            "Authorization": "Bearer " + CHAVE_OPENAI,
            "Content-Type": "application/json"
        },
        body: JSON.stringify({
            model: MODELO_GPT,
            messages: [
                { role: "system", content: instrucao },
                { role: "user", content: conteudo }
            ],
            // Temperatura baixa deixa a resposta mais previsivel e menos
            // criativa, que e o que se quer quando ela fala de preco.
            temperature: 0.2
        })
    });

    if (!resposta.ok) {
        const erro = await resposta.text();
        throw new Error("A OpenAI recusou: " + resposta.status + " " + erro);
    }

    const dados = await resposta.json();
    return {
        texto: dados.choices[0].message.content,
        tokens: dados.usage
    };
}

async function main() {
    if (!CHAVE_OPENAI) {
        console.log("Falta a chave. Rode assim:");
        console.log('  OPENAI_API_KEY="sua-chave" node perguntar.js "sua pergunta"');
        return;
    }

    const pergunta = process.argv[2];
    if (!pergunta) {
        console.log('Uso: node perguntar.js "quero um pc para jogos ate 2000 reais"');
        return;
    }

    const modelo = await pipeline("feature-extraction", MODELO_EMBEDDING);
    const cliente = new QdrantClient({ url: ENDERECO, apiKey: CHAVE_QDRANT });

    const produtos = await buscarProdutos(cliente, modelo, pergunta);

    if (produtos.length === 0) {
        console.log("Nao achei nenhum produto para essa busca.");
        return;
    }

    const contexto = montarContexto(produtos);

    console.log("");
    console.log("PERGUNTA: " + pergunta);
    console.log("");
    console.log("O QUE A BUSCA ACHOU:");
    console.log(contexto);
    console.log("");

    const resultado = await pedirResposta(pergunta, contexto);

    console.log("RESPOSTA DO GPT:");
    console.log(resultado.texto);
    console.log("");
    console.log("tokens: " + resultado.tokens.prompt_tokens + " entrada + " +
        resultado.tokens.completion_tokens + " saida");
    console.log("");
}

main();
Salve como perguntar.js, na mesma pasta do buscar.js do artigo anterior, e rode:
OPENAI_API_KEY="sua-chave" node perguntar.js "quero um pc para jogos ate 2000 reais"São umas 40 linhas de RAG sobre uma busca que já existia. A parte difícil, mesmo, ficou nos dois artigos anteriores. 🦄
Por hoje é só, meus unicórnios! 🦄✨
Que a magia do arco-íris continue brilhando em suas vidas! Até mais! 🌈🌟
Perguntas frequentes
O que é RAG?
Por que não perguntar direto ao ChatGPT, sem banco vetorial?
Por que não basta uma busca com LIKE no MySQL?
LIKE compara letra por letra e o cliente não digita o nome do produto. Com os mesmos 8 itens cadastrados, LIKE '%computador%' devolveu 2 resultados e deixou de fora os dois PCs Gamer e os dois notebooks; LIKE '%pc para jogos%' devolveu zero. A busca vetorial acha os quatro, porque entende que notebook é um computador sem ninguém ter escrito isso.Como impedir que o modelo invente informação no RAG?
system, mandando usar somente os dados fornecidos e dizer que não sabe quando a informação não estiver ali. A diferença é enorme: sem essa instrução, ao ser perguntado sobre a garantia de um PC, o modelo respondeu "1 ano de garantia e fonte de 500W", dados que não existiam em lugar nenhum. Com ela, respondeu que não tinha essa informação.Quanto custa rodar um RAG com a OpenAI?
gpt-4o-mini, o que dá uma fração de centavo. A parte da busca, que roda no seu servidor, não custa nada por uso: só o GPT é cobrado.Qual etapa do RAG é a mais lenta?
stream uma boa ideia numa interface de chat.A chave da OpenAI pode ficar no código?
process.env.OPENAI_API_KEY, e o arquivo .env entra no .gitignore. Chave escrita no código vaza no primeiro git push, e continua no histórico mesmo depois de você apagá-la do arquivo.Leia também
API Mágica: CEP e Pix de graça, sem cartão
Lancei a API Mágica: CEP, QR Code Pix, geradores e mais, de graça. Veja como consultar e gerar com Node.js em poucas linhas.
Resend: enviando e recebendo e-mails com Node.js
Tutorial da Resend com Node.js: criar a chave, enviar com fetch, verificar o domínio e receber e-mails por webhook conferindo a assinatura.
Node.js: testando scripts de scraping no ScrapingCourse
O ScrapingCourse é um site feito para treinar scraping. Cinco desafios dele em Node.js, e a armadilha real que cada um esconde.